llama.cpp prompt lookup 42배, 로컬 LLM 속도 오해 2가지 제대로 짚기
 퀀텀점프클럽 정상록9분 읽기2 views
무료 자료
PDF · 무료
AI 성능 숫자, 속지 않고 읽는 법 — 비개발자를 위한 쉬운 가이드
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
llama.cpp prompt lookup 42배, 로컬 LLM 속도 오해 2가지 제대로 짚기
원문까지 따라가 보니 두 가지가 부풀려져 있었습니다
"llama.cpp가 42배 빨라졌다"는 글이 최근 커뮤니티에 쫙 퍼졌어요. 그런데 원문(깃허브 PR, 원저자 리포트, Hacker News 스레드)까지 직접 따라가 보니 두 가지가 부풀려져 있었습니다.
"그럼 제 로컬 LLM도 진짜 42배 빨라지는 건가요?" 이 질문, 커뮤니티 여러 곳에서 반복해 나왔죠.
이 글에서는 llama.cpp prompt lookup drafting 42배라는 표현이 정확히 무엇을 가리키는지 원문 대조로 짚어봅니다. 쓸 만한 부분과 켜는 법까지 정리했어요.
"42배"라는 숫자, 정확히 어디서 나온 걸까요
원문을 따라가 보면 이 42배 최적화는 llama.cpp 본진, 즉 upstream 저장소 ggml-org/llama.cpp에 들어간 게 아니에요. 코드는 원저자 개인 포크(jadidbourbaki/llama.cpp)의 PR 5건(#2, #5, #7, #10, #12)에만 담겨 있습니다. 이 글을 쓰는 오늘(2026-09-29) 기준 다섯 건 모두 OPEN 상태예요. 병합 대상(base)조차 포크 자기 브랜치입니다.
ggml-org/llama.cpp에서 작성자 기준(author:jadidbourbaki)으로 검색하면 결과가 0건이에요. 원저자는 사흘 전(2026-09-26) Hacker News에서 "이 문제 때문에 llama.cpp 저장소에 PR이나 이슈를 만들 수 없다"고 직접 밝혔습니다. 왜 그런 제재를 받았는지는 확정된 사실관계가 없어요. 다만 제3자가 대신 올려주지 않으면 이 코드가 일반 설치 경로로 들어올 길이 없다는 결론은 분명합니다.
여기서 자주 헷갈리는 지점이 있어요. prompt lookup decoding(입력 프롬프트를 되짚어 다음 토큰을 미리 찍는 방식) 기능 자체는 2023년 12월 22일 upstream에 이미 병합됐고, 지금도 살아 있습니다. 42배 최적화와 기능 자체는 다른 이야기예요. 기능은 정식으로 쓸 수 있고, 42배는 그 기능을 더 빠르게 만들려는 실험적 코드일 뿐입니다.
두 번째 착각, "내 PC 응답이 42배 빨라진다"는 아닙니다
원저자 리포트의 원문 요약은 이렇습니다. "drafting을 최대 42배 빠르게, 메모리는 최대 2.6배 적게 만들었다." 42배가 걸리는 대상은 드래프팅(drafting, 다음에 올 토큰을 미리 찍어보는 초안 생성 단계) 하나뿐이에요. 전체 응답 속도, 즉 tok/s(초당 생성 토큰 수로 나타내는 체감 응답 속도)는 별개 숫자입니다.
측정 도구도 볼 필요가 있어요. 원저자의 llama-lookup-stats는 실제 추론을 돌리지 않고, 파일 속 텍스트를 "모델 출력"으로 가정해 드래프팅 루프만 재생합니다. 그래서 원저자 리포트·포크 PR·Hacker News 어디에도 tok/s 수치가 없어요. HN에서 사용자 S0y도 "체감 tok/s는 얼마나 빨라지나요?"라고 물었지만, 이 글을 쓰는 시점까지 답이 없습니다.
측정 조건은 이렇습니다. Apple M4 Pro 14코어, 메모리 48GB, macOS 26.5.1 환경에서 WikiText-103 코퍼스(위키 텍스트 모음)를 컨텍스트 4,096 토큰 기준으로 3회 실행해 중앙값을 낸 결과예요.
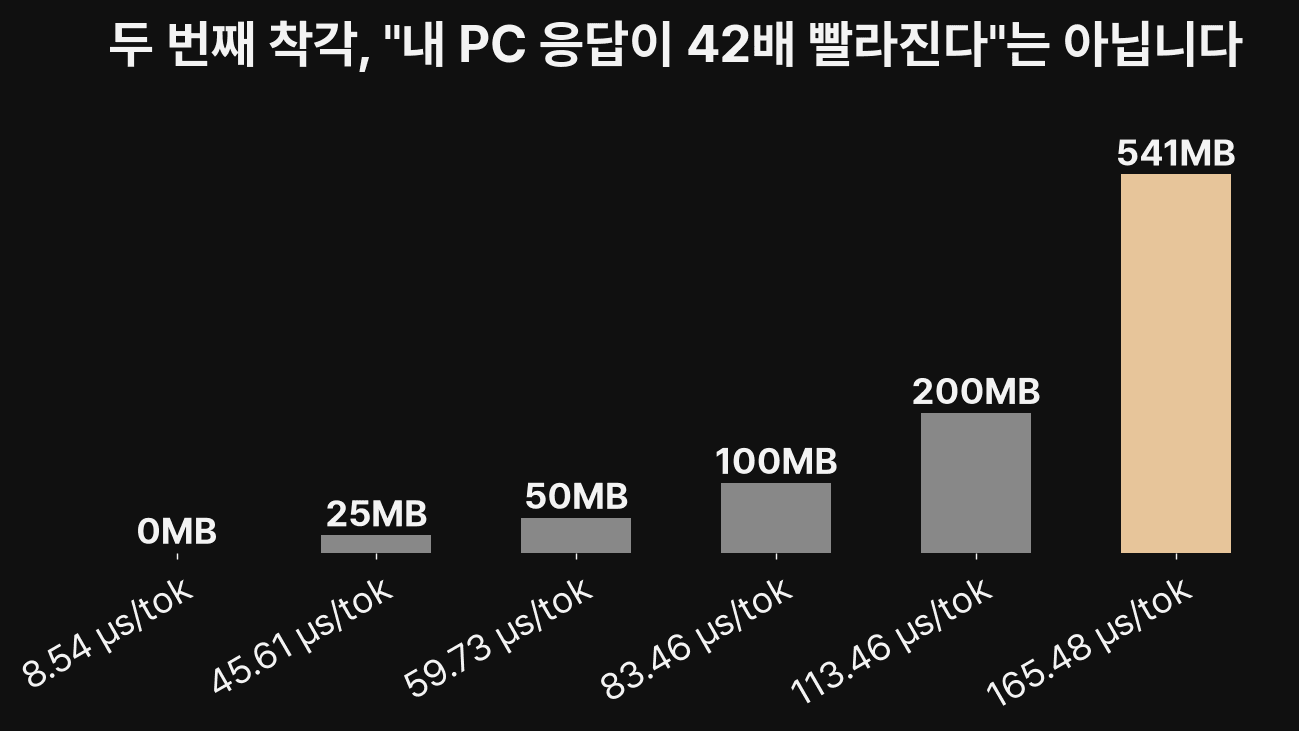
규모 감각을 잡아볼게요. 정적 캐시가 가장 큰 541MB에서 최적화 이전 지연은 토큰당 165.48µs(0.165ms)였고, 로컬 LLM이 토큰 1개를 만드는 데는 보통 수십 ms가 걸립니다. 42배가 줄인 건 전체 시간의 아주 작은 조각이라, 체감 속도도 그만큼만 움직입니다(암달의 법칙).
| 정적 캐시 코퍼스 크기 | 최적화 이전 | 최적화 이후 |
|---|---|---|
| 0MB | 8.54 µs/tok | 1.89 µs/tok |
| 25MB | 45.61 µs/tok | 4.12 µs/tok |
| 50MB | 59.73 µs/tok | 4.42 µs/tok |
| 100MB | 83.46 µs/tok | 4.64 µs/tok |
| 200MB | 113.46 µs/tok | 5.62 µs/tok |
| 541MB | 165.48 µs/tok | 6.47 µs/tok |
(단위: 토큰 1개를 초안으로 뽑는 데 걸리는 시간. µs(마이크로초)는 100만분의 1초)
이후 Daniel Lemire가 임계값을 미리 걸러내는 최적화를 추가해, 원저자는 누적 최대 140배까지 갔다고 업데이트했습니다. 140배도 드래프팅 지연 얘기일 뿐 tok/s 얘기는 아니에요.
그럼에도 진짜 쓸모 있는 이유는 속도가 아니라 이겁니다
여기까지만 보면 별거 아니라고 느낄 수 있지만, 실무에서 체감되는 개선은 메모리와 시작 시간에 있습니다.
541MB 코퍼스로 정적 캐시를 만들 때 로딩 시간이 3.76초에서 0.23초로 줄었습니다. 최대 메모리 사용량도 1.71GB에서 1.31GB로 줄었고요. 서버를 자주 재시작하거나 여러 캐시를 바꿔가며 쓰는 로컬 환경에서는 이쪽이 훨씬 체감됩니다.
품질 걱정은 안 하셔도 돼요. speculative decoding(추측 생성, 보조 모델이 다음 말을 미리 여러 개 찍어두면 원본 모델이 검증 단계에서 채점해 맞은 만큼만 건너뛰고 틀린 후보는 버리는 기법)은 후보만 제안합니다. prompt lookup decoding은 그 보조 모델 대신 프롬프트 속 n-gram(연속된 토큰 몇 개짜리 묶음) 검색으로 대체한 것뿐이라, 켜도 출력 텍스트는 안 켰을 때와 똑같습니다.
prompt lookup decoding은 초안 모델을 따로 두지 않고, 지금까지 나온 입력 토큰을 검색해 다음에 올 말을 미리 제안하는 방식입니다. 제안이 맞는지는 원본 모델이 그대로 채점하므로 출력 품질에는 영향이 없습니다.
실제로 켜는 법: 플래그와 순서
ggml-org/llama.cpp master 소스 기준(2026-09-29)으로 정리했습니다. n-gram 캐시 방식은 기본값이 꺼져 있어서 명시적으로 켜야 해요.
- 기능을 켜는 플래그:
--spec-type ngram-cache - 정적 캐시 파일:
--lookup-cache-static(축약-lcs) - 동적 캐시 파일:
--lookup-cache-dynamic(축약-lcd) - 초안 토큰 개수:
--spec-draft-n-max
-lcs와 -lcd는 llama-server에서도 동작해, 서버로 띄운 상태에서도 캐시를 붙일 수 있습니다.
# 정적 캐시 생성 (모델의 토크나이저로 코퍼스를 토큰화)
llama-lookup-create -m 모델.gguf -f 코퍼스.txt -lcs 내캐시.bin

# 서버에서 사용
llama-server -m 모델.gguf --spec-type ngram-cache \
  -lcs 내캐시.bin -lcd 동적캐시.bin
주의할 점이 하나 있습니다. --spec-ngram-size-n 같은 예전 플래그는 upstream에서 이미 제거됐어요. 오래된 블로그 글의 명령을 그대로 복사하면 실행이 실패합니다. 지금 upstream에는 ngram-cache 말고도 ngram-simple, ngram-map-k, ngram-map-k4v, ngram-mod까지 n-gram 방식이 여러 개로 나뉘어 있고, 42배 최적화가 건드린 건 그중 가장 오래된 ngram-cache 경로 하나뿐이에요.
어떤 작업엔 통하고, 한국어에는 얼마나 통할까요
n-gram 검색은 프롬프트에 없던 내용은 절대 베낄 수 없어서, 입력과 출력이 많이 겹치는 작업에서만 적중률(hit rate, 미리 찍은 초안이 실제로 채택되는 비율)이 오릅니다.
| 이득이 큰 작업 | 이유 |
|---|---|
| 코드 편집, 리팩터링 | 원본 코드 대부분이 출력에 그대로 재등장 |
| 문서 요약, RAG 답변 | 원문 표현을 그대로 인용하며 답함 |
| 구조화 출력(JSON, XML) | 키 이름과 구분자가 반복 |
| 교정, 문체 수정 | 입력 문장 대부분이 유지됨 |
| 이득이 거의 없는 작업 | 이유 |
|---|---|
| 새 글 창작, 브레인스토밍 | 되짚을 원본 자체가 없음 |
| 짧은 프롬프트의 긴 답변 | 검색 대상 자체가 작음 |
한국어 적중률을 직접 측정한 공식 자료는 찾지 못해, 여기서부터는 근거와 추론을 나눠서 말씀드릴게요.
근거로 확인된 부분은 이렇습니다. 매칭은 글자가 아니라 토큰 단위로 이뤄지고, 한국어 코퍼스로도 정적 캐시를 만들 수 있습니다. 다만 정적 캐시는 모델 토크나이저에 묶여 있어, 모델을 바꾸면 다시 만들어야 해요.
추론에 해당하는 부분은 이렇습니다. 한국어는 조사와 어미가 붙는 교착어라 같은 의미라도 표면 토큰열이 조금씩 달라지기 쉬워요. 코드처럼 문자 단위로 그대로 반복되는 텍스트보다 적중률이 낮게 나올 가능성이 있습니다. 원리에서 나온 예상이고, 실측치는 아니에요.
반대로 한국어 실무에도 겹침이 큰 작업은 분명히 있습니다. 계약서·약관 검토, 회의록 요약, 사내 문서 기반 질의응답, 보고서 문체 교정, 코드 리뷰가 그렇죠. 입력 문장이 출력에 거의 그대로 다시 등장하니까요.
추측하지 말고 직접 재보는 게 정석입니다. llama-lookup-stats로 적중률을 측정하고, --spec-type ngram-cache를 켠 상태와 끈 상태의 tok/s를 직접 비교해 보세요. 42배는 이 비교의 답이 아니에요.
도입할 때 함께 알아둘 트레이드오프
코퍼스가 커질수록 드래프팅 자체가 느려진다는 점은 자주 놓치는 부분입니다. 최적화 이전 기준으로 0MB에서 8.54 µs/tok이던 지연이 541MB에서는 165.48 µs/tok까지, 약 19배 늘어나요. 큰 정적 캐시는 공짜가 아닙니다.
정적 캐시는 모델 토크나이저에 묶여 있어서 모델을 바꾸면 다시 만들어야 합니다. 동적 캐시는 이전 대화의 n-gram 빈도를 파일로 계속 보존해요. 사내 민감 문서로 작업한다면 이 동적 캐시 파일을 어떻게 취급할지 정책이 필요합니다.
커뮤니티에 도는 숫자 중에는 검증되지 않은 것도 있어요. Reddit r/LocalLLaMA 게시물의 점수(약 225점)와 RTX 3090 환경의 HackMD 벤치마크는 이 리서치에서 직접 확인하지 못했습니다. 미검증 커뮤니티 보고로만 남겨둡니다.
자주 묻는 질문
지금 llama.cpp를 업데이트하면 42배 최적화가 바로 적용되나요?
아니요. 42배 최적화는 원저자 개인 포크의 PR에만 있고, 이 글을 쓰는 시점까지 전부 OPEN 상태라 본진에 제출조차 되지 않았습니다. 최신 릴리스를 받아도 이 코드는 포함돼 있지 않아요.
사용자가 실제로 느끼는 응답 속도(tok/s)는 얼마나 빨라지나요?
확인된 수치가 없습니다. Hacker News에서도 같은 질문이 나왔지만 답이 달리지 않았어요. 42배는 드래프팅 단계의 1토큰당 지연시간이라, 전체 응답 속도와는 다른 숫자입니다.
한국어 작업에도 이 기능이 도움이 될까요?
매칭은 토큰 단위라 한국어에서도 동작하지만, 교착어 특성상 적중률이 코드보다 낮을 가능성이 있어요(원리에서 나온 추론이지 실측은 아닙니다). 계약서 검토나 회의록 요약처럼 겹침이 큰 작업이라면 직접 측정해 보시는 게 정확합니다.
마무리
숫자 하나가 커뮤니티를 돌 때는 "이게 정확히 뭘 측정한 숫자인지"부터 확인하는 습관이 오래 남습니다. llama.cpp 42배 수치는 병합된 기능이 아니라 미병합 포크의 드래프팅 지연이었고, 실제 응답 속도 개선치는 아직 확인되지 않았습니다. 그래도 쓸모없는 코드는 아니에요. 정적 캐시 로딩 시간과 메모리 사용량은 실측으로 줄었고, 출력 품질에는 영향이 없습니다.
어디서부터 손대야 할지 막막하다면, 지금 팀에서 반복적으로 겹치는 문서 작업 하나를 골라 보세요. 그 하나가 시작점입니다.