Opus 5.5 vs GPT-6 Astra·Sol: 90분 차이로 쏟아진 모델 3개, 뭐가 다를까? (2026)
 퀀텀점프클럽 정상록11분 읽기22 views
무료 자료
PDF · 무료
AI 모델 가격이 하루 만에 크게 떨어진 이유
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
Claude Opus 5.5 vs GPT-6 Astra·Sol: 2026년 90분 차이로 갈린 가격과 성능
같은 날 90분 간격으로 세 모델이 쏟아졌습니다. LLM 가격이 실제로 얼마나 내렸고 벤치마크를 어떻게 읽어야 속지 않는지, 실전 AI 모델 비교로 정리했어요.
토큰: AI가 글을 처리하고 요금을 매기는 최소 단위입니다. 100만 토큰은 한글로 대략 장편소설 한 권 분량이에요.
effort: 모델이 답하기 전에 얼마나 깊이 생각할지 정하는 설정값입니다. 높일수록 정확해지지만 토큰을 더 씁니다.
목차
- 왜 하루에 세 개의 AI 모델이 쏟아졌을까요?
- 세 모델의 스펙과 가격은 어떻게 다를까요?
- 벤치마크에서는 누가 이겼을까요?
- Opus 5.5를 쓰기 전 알아야 할 변경사항이 있나요?
- 어떤 모델을 골라야 할까요?
왜 하루에 세 개의 AI 모델이 쏟아졌을까요?
2026년 9월 3일, OpenAI가 GPT-6 Astra를 먼저 공개했습니다. 19일 뒤인 9월 22일에는 Anthropic의 Claude Opus 5.5와 OpenAI의 GPT-6 Sol·Luna가 90분 간격으로 잇달아 나왔어요. 같은 날 두 회사가 신모델을 내놓은 셈이죠.
세 모델은 지향점이 다릅니다. Opus 5.5는 에이전트형 코딩과 지식노동을, GPT-6 Astra는 프런티어 수준의 수학·과학 문제를, GPT-6 Sol과 Luna는 대량 처리와 비용 절감을 겨냥했습니다. 겹치는 시점에 나왔다고 같은 용도로 경쟁하는 건 아니에요.
세 모델의 스펙과 가격은 어떻게 다를까요?
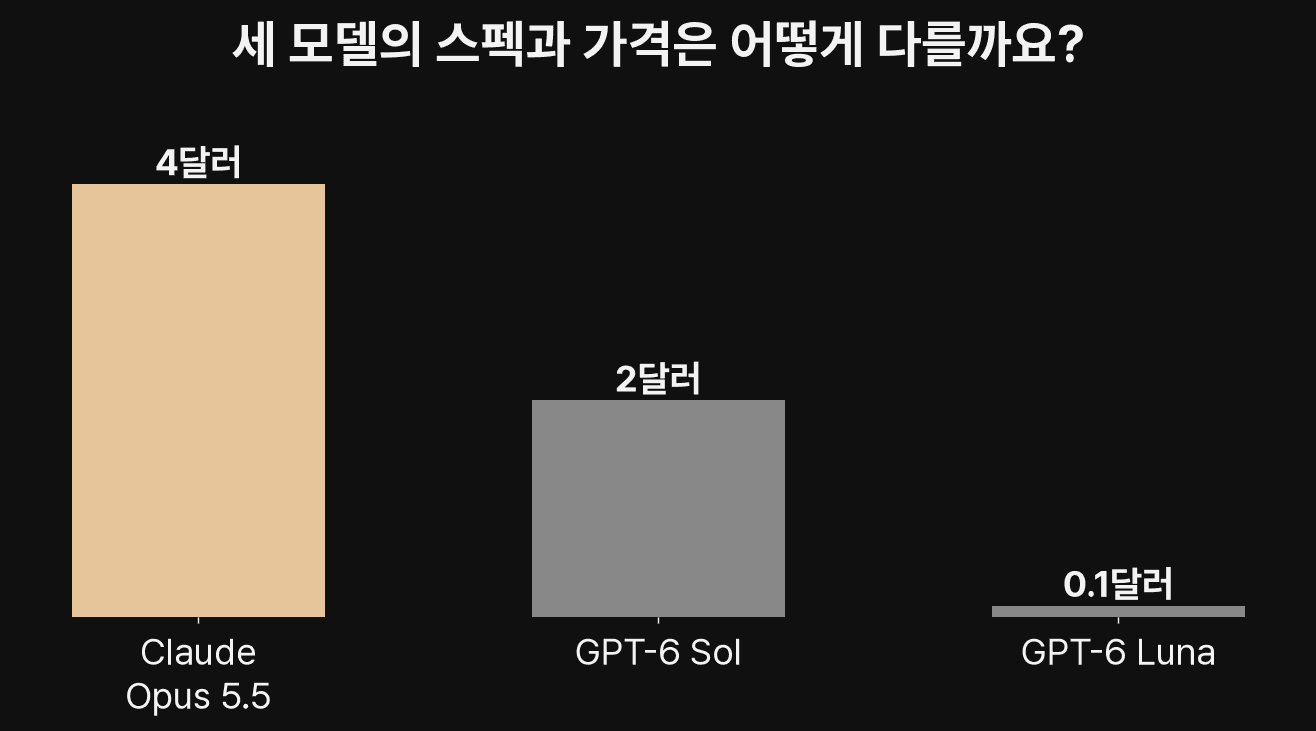
가장 눈에 띄는 차이는 가격입니다. Anthropic·OpenAI 공식 발표 기준으로 정리하면 다음과 같아요.
세 모델의 스펙과 가격은 어떻게 다를까요?
자료: platform.claude.com · QJC 재구성
| 모델 | 출시일 | 입력(100만 토큰) | 출력(100만 토큰) | 컨텍스트(입력 처리 범위) | 지식 컷오프 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 2026-09-22 | $4 | $20 | 100만 | 2026년 6월 |
| GPT-6 Astra | 2026-09-03 | $10(27.2만 토큰 초과 시 $20) | $50(초과 시 $75) | 105만 | 2026-04-30 |
| GPT-6 Sol | 2026-09-22 | $2 | $10 | 105만 | 2026-04-20 |
| GPT-6 Luna | 2026-09-22 | $0.10 | $0.50 | 105만 | 2026-05-18 |
Opus 5.5의 입력 가격은 Astra의 40% 수준이고 캐시 읽기 비용은 5배 저렴해요. 반대로 Astra는 요청 하나가 27.2만 토큰을 넘으면 전체 요청에 더 비싼 단가가 소급 적용됩니다. OpenAI는 Sol·Luna의 가격 인하가 한시 프로모션이 아니라 영구 적용이라고 VentureBeat에 확인해줬습니다.
벤치마크에서는 누가 이겼을까요?
Anthropic 공식 벤치마크에서는 Opus 5.5가 대체로 앞서요. 다만 Astra가 이긴 항목도 분명히 있습니다.
 벤치마크에서는 누가 이겼을까요?
자료: 본문 데이터 · QJC 재구성
| 벤치마크 | Opus 5.5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4%(xhigh) | 57.9%(high) | 37.3% |
| Terminal-Bench-Science | 58.7% | 64.6% | 22.4% |
| AutomationBench(Zapier) | 40.0% | 41.4% | 28.8% |
| SWE-bench Pro | 89.9% | 미공개 | — |
Astra가 이긴 두 항목, Terminal-Bench-Science와 AutomationBench를 빼놓으면 왜곡된 요약이 돼요. 참고로 Opus 5.5는 SWE-bench Verified 점수를 공개하지 않았습니다. Pro(89.9%)와 Multilingual(93.9%), Multimodal(61.4%)만 발표했으니, 어딘가에서 "Opus 5.5의 SWE-bench Verified 점수"를 보면 제3자 측정치라는 뜻이죠.
독립 검증 결과는 조금 다른 그림을 보여줍니다. Artificial Analysis 측정에 따르면 지능 지수(v4.3.2, 2026-09-22 기준)에서 Opus 5.5(max)는 58점으로 1위, GPT-6 Astra는 53점이었어요. 같은 측정에서 Terminal-Bench 4.0은 59.6%로 나와 Anthropic 자체 발표 66.4%와 차이가 있습니다. Artificial Analysis는 이 수치가 Anthropic의 기본 안전장치를 켠 상태로 측정한 값이라고 밝혔어요. ARC Prize 검증에 따르면 Astra의 ARC-AGI-3 점수도 표준 API 호출로는 62.7%에 그쳤고, 흔히 인용되는 99.9%는 별도 제작된 전용 하네스(측정 도구)로 얻은 수치였습니다.
한 가지 더, Anthropic이 내세우는 "40% 비용 절감"은 기본 effort(추론 강도) 설정끼리 비교한 값이에요. Opus 5는 high, Opus 5.5는 medium이 기본값이거든요. 반면 위 표의 벤치마크 점수는 대부분 최고 강도인 max effort로 측정했으니, 비용 절감과 벤치마크 점수를 같은 조건으로 착각하면 안 됩니다.
Opus 5.5를 쓰기 전 알아야 할 변경사항이 있나요?
네, 기존 API 코드를 그대로 쓰면 막히는 지점이 있어요. 첫째, thinking을 끌 수 없습니다. 시도하면 오류가 나고 깊이는 effort 파라미터로만 조절해요. 둘째, 강제 tool_choice 방식이 지원되지 않습니다. 셋째, thinking 블록은 모델과 대화에 묶여서 다른 모델로는 재사용할 수 없어요. 넷째, computer_20251124 도구가 폐지되고 computer_toolset_20260801로 바뀌었습니다.
여기에 잘 알려지지 않은 다섯 번째 변화가 있어요. 도구 호출 사이의 텍스트가 기본 설정에서는 빈 thinking 블록으로 반환됩니다. 그 텍스트를 진행 상황으로 화면에 띄우던 앱은 요청이 성공해도 화면이 조용해져요. 테스트는 통과하니 문제를 늦게 발견하기 쉽습니다. display 옵션을 updates나 summarized로 바꿔야 해결돼요.
GPT-6 Sol은 정말 더 똑똑해졌을까요?
정확히 말하면 아닙니다. DeepSWE 벤치마크에서 GPT-6 Sol의 최고 점수는 68.8%로, 이전 세대인 GPT-5.6 Sol의 72.7%보다 오히려 낮아요. OSWorld 2.0도 64.4%로 이전 세대 66.2%에 못 미칩니다.
대신 비용이 확 줄었어요. 같은 비용 기준으로 보면 이야기가 달라집니다. AutomationBench에서 GPT-6 Sol(xhigh)은 작업당 0.27달러로 33.2%를 기록했는데, Opus 5(max)는 Sol보다 11.1배 비싼 비용을 쓰고도 26.9%에 그쳤어요. 성능 천장이 올라간 게 아니라, 같은 돈으로 더 많은 일을 처리하도록 비용 곡선이 이동한 거죠.
개발자들은 실제로 뭐라고 말할까요?
공식 발표 영상 반응부터 볼게요. Anthropic이 공개한 Opus 5.5 소개 영상은 좋아요 80,900개, 조회수 1,500만 회를 기록했습니다. 그 아래 실사용 후기는 엇갈려요.
Hacker News 사용자 accrual은 이렇게 평가했습니다. "Opus 5.5로 하루 작업해 봤다. 결과가 강하고 포괄적이다. Opus 5.0의 어색한 'claudish' 말투가 사라졌고 소통이 자연스럽고 읽기 편하다."
반대 의견도 만만치 않습니다. 사용자 bobbylarrybobby는 "Opus 5.5가 5.0이 남긴 주석이 많은 코드 구역에서 그 스타일을 그대로 따라 했다. 지시를 줄여도 되게끔 주변을 모방하도록 훈련된 것 같은데, 그 결과 5가 건드린 코드베이스 부분이 바이럴처럼 퍼진다"고 지적했어요. 사용자 rmunn은 코드 리뷰에서 지적된 문제 5개 중 4개가 존재하지 않는 줄 번호를 가리켰다고 보고했습니다.
어떤 모델을 골라야 할까요?
용도에 따라 답이 갈립니다.
| 용도 | 추천 모델 |
|---|---|
| 에이전트형 코딩 | Claude Opus 5.5 |
| 지식노동(문서·분석) | Claude Opus 5.5 |
| 프런티어 수학·과학 연구 | GPT-6 Astra |
| 대량 처리·비용 민감 작업 | GPT-6 Sol·Luna |
| 27.2만 토큰 넘는 초장문 입력 | Claude Opus 5.5 |
OpenAI가 공개한 FrontierCode Main 교차 측정에서 Opus 5의 수치 편차는 5.4포인트였는데, 이는 Opus 5.5가 Astra를 앞선다고 주장하는 격차 1.1포인트보다 큽니다. 벤치마크 하나로 결론 내리기보다 자신의 실제 작업으로 직접 재보는 쪽이 정확해요.
자주 묻는 질문
Opus 5.5와 GPT-6 Astra 중 코딩에는 뭐가 나을까요?
Anthropic 공식 벤치마크 기준으로는 Terminal-Bench 4.0(66.4% vs 57.9%)과 SWE-bench 계열에서 Opus 5.5가 앞섭니다. 다만 Astra는 Terminal-Bench-Science(64.6%)와 AutomationBench(41.4%)에서 Opus 5.5를 이겼으니 작업 성격에 따라 갈려요.
GPT-6 Sol과 GPT-5.6 Sol 중 뭐가 더 나을까요?
DeepSWE 최고 점수만 보면 GPT-5.6 Sol(72.7%)이 GPT-6 Sol(68.8%)보다 높습니다. 대신 GPT-6 Sol은 가격이 50% 내려갔으니, 같은 비용 대비 성능으로는 GPT-6 Sol이 유리해요.
Opus 5.5 API를 쓰던 코드를 그대로 써도 되나요?
안 됩니다. thinking을 끄는 옵션, 강제 tool_choice, computer_20251124 도구 등 네 지점에서 오류가 날 수 있어요. 마이그레이션 가이드를 먼저 확인하는 게 안전합니다.
GPT-6 Astra가 정말 에니그마 암호를 풀었나요?
정확히는 1941년 7월 10일에 만들어진 특정 메시지 한 건의 키와 평문을 복원한 거예요. 사용된 암호해독 기법 자체는 제2차 세계대전 시기와 그 이전부터 있던 것이라 현대 암호체계와는 무관합니다. 에니그마 연구자 Frode Weierud가 결과를 검증했습니다.
Artificial Analysis 점수와 Anthropic 자체 발표가 다른 이유는 뭔가요?
Artificial Analysis는 Anthropic의 기본 안전장치가 켜진 상태에서 측정했다고 밝혔습니다. 이 수치는 모델 자체의 순수 성능이 아니라 전체 서비스 구성을 반영한 값이라는 뜻이에요.
참고 자료
- Anthropic 공식: Claude Opus 5.5 발표
- Claude 플랫폼 문서: Opus 5.5 신기능
- Claude 플랫폼 문서: Opus 5.5 마이그레이션 가이드
- OpenAI 공식: GPT-6 Astra 발표
- OpenAI 공식: GPT-6 Sol·Luna 발표
- Artificial Analysis: Opus 5.5 지능 지수 1위 분석
- Artificial Analysis: Sol·Luna 비용 효율 분석
- ARC Prize: Opus 5.5 ARC-AGI 독립 검증
- CryptoCellar: 1941년 에니그마 전문 MVUEH 해독 기록
- VentureBeat: OpenAI가 API 가격을 50% 이상 인하했다는 보도
마무리
Claude Opus 5.5든 GPT-6 Astra든, 벤치마크는 참고용일 뿐이에요. 자신의 워크로드로 직접 재보는 것이 어떤 벤치마크보다 정확합니다.