Jev AI 완벽 가이드 2026: TypeSafe가 만든 판단 전용 모델, 언제 어떻게 써야 할까
 퀀텀점프클럽 정상록8분 읽기14 views
무료 자료
PDF · 무료
Jev AI 총정리 언제 어떻게 써야 할까 — 비개발자를 위한 쉬운 가이드
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
Jev AI 완벽 가이드 2026: TypeSafe가 만든 판단 전용 모델, 언제 어떻게 써야 할까
Jev는 대체 무엇인가요?
Jev는 문장을 만들지 않는 AI예요. state(현재 상황)를 한 번 읽고, 타입으로 정의된 질문들에 확률분포를 병렬로 돌려주는 구조라 파싱이 필요 없고 스키마 밖 값이 나올 수가 없습니다. TypeSafe AI가 2026년 9월 15일 공개한 발표에 따르면, 개발은 2년간 스텔스로 진행됐고 DCVC 주도로 4천만 달러 규모의 시드 투자를 받았어요. 만든 사람은 전 OpenAI 소속으로 InstructGPT와 RLHF를 공동 개발한 Diogo Almeida입니다. 현재는 typesafe.ai에서 대기 명단에 등록한 뒤 승인을 받아야 콘솔과 API를 쓸 수 있는 얼리 액세스 단계예요.
Jev는 대체 무엇인가요?
이미지 출처: typesafe.ai
왜 이렇게 빠르고 싼가요?
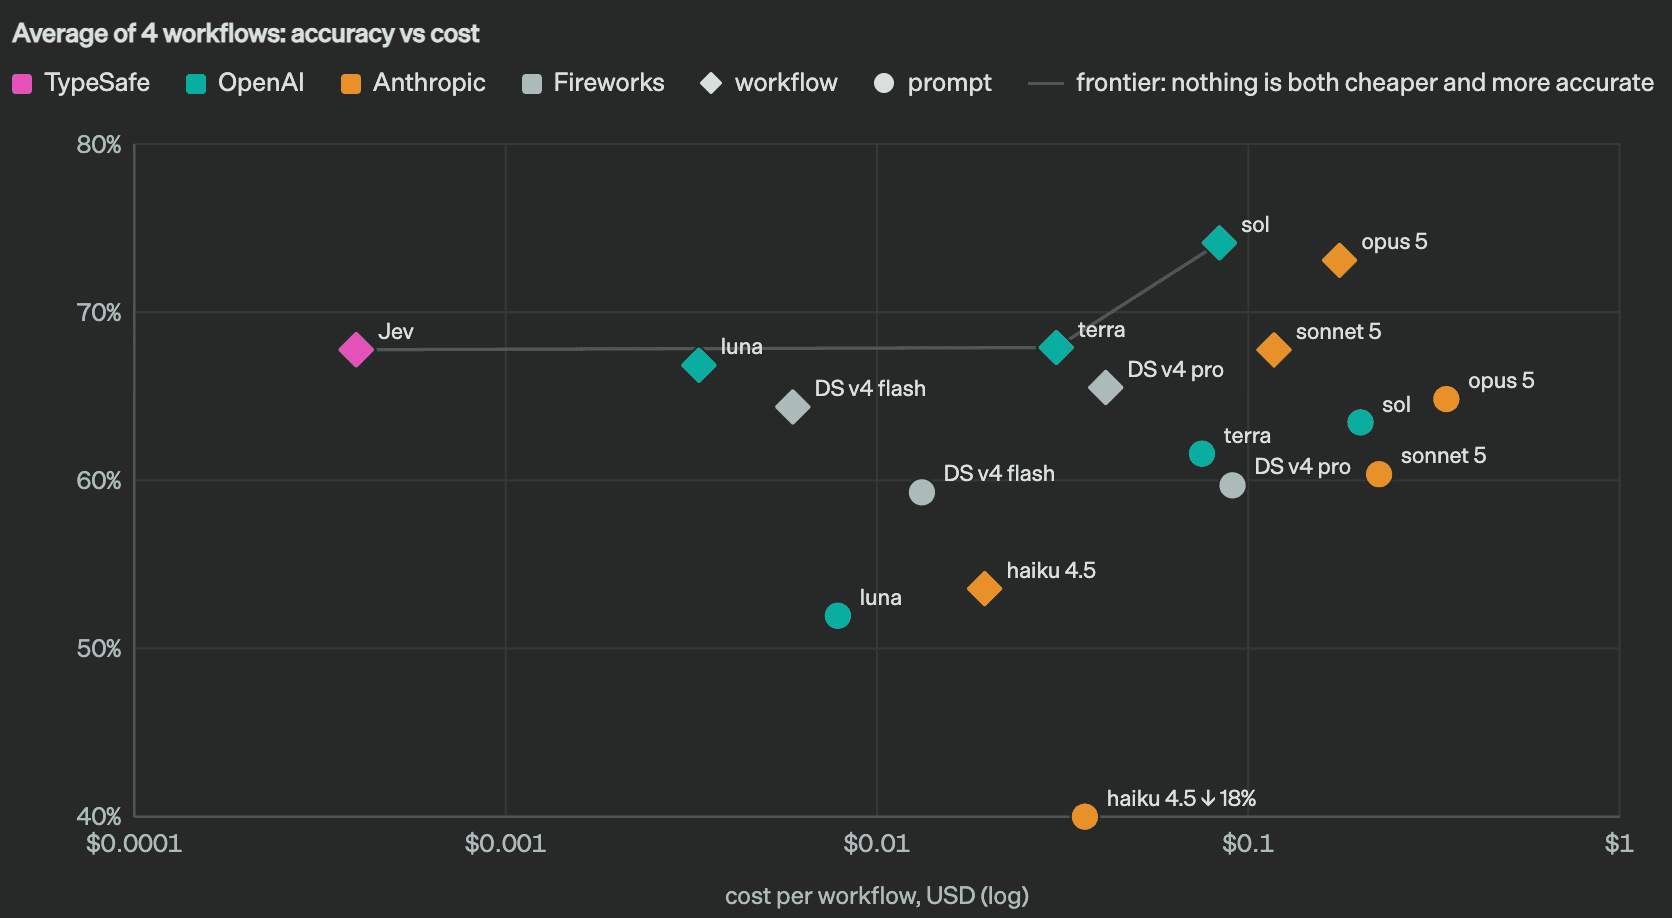
공식 가격은 입력 100만 토큰당 0.042달러이고 출력 토큰은 아예 무료입니다. 지연시간은 미국 서부 리전 기준으로 70~500ms 사이로 알려져 있어요. TypeSafe 공식 문서는 세 가지 질문 형식(선택·점수·참거짓)을 한 번의 API 호출에 섞어 쓸 수 있고, 질문 수를 늘려도 응답시간이 거의 그대로 유지된다고 설명합니다. 공개 시연에서는 같은 27개 질문에 대해 Jev가 0.114초, 기존 추론 모델인 GPT-5.6 Terra가 8.566초로 큰 차이가 났어요. 속도와 비용 우위는 발표마다 엇갈려서 속도는 20배에서 200배, 비용은 40배에서 400배까지 차이가 난다고 알려져 있는데, TypeSafe 스스로도 항상 재현되는 수치는 아니라고 인정하고 있습니다.
어떤 일에 써야 하나요
경제성의 핵심은 같은 state에 판단을 여러 번 붙일수록 유리해진다는 점이에요. 실무 사례로는 논문 1,018개를 24개 주제로 자동 분류하면서 건당 중앙값 256ms, 전체 0.08달러가 든 경우, 광고 724개를 37개 브랜드로 40초 만에 분석한 경우가 보고됐습니다. infision.ai가 2026년 9월 18일 공개한 KLUE-YNAT 벤치마크에서는 뉴스 제목 9,107건을 7개 섹션으로 분류할 때 Jev가 정확도 0.760, 지연 269ms, 1,000건당 0.02달러를 기록했어요. 의도 분류, 에이전트의 다음 행동 선택, 모델 라우팅, 가드레일, 위험 점수화처럼 정해진 선택지 중에서 빠르게 고르는 업무에 특히 적합합니다.
 어떤 일에 써야 하나요
자료: 본문 데이터 · QJC 재구성
어떤 일에는 쓰면 안 되나요?
열린 형식의 추출이나 지식 집약적인 질의응답, 여러 단계를 거쳐야 하는 추론, 산술이나 개수 세기, 요약과 설명, 코드나 산문 생성은 Jev의 영역이 아니에요. ebrain.lab이 실시한 40문장 테스트에서는 문장 하나씩 물어봤을 때 40개 중 40개를 맞혔지만, 80개 질문을 한 문서에 통째로 물어보자 정답이 25개(62%)로 뚝 떨어졌습니다. 자연스러운 문장 20개 중 13개를 번역투로 잘못 판정한 것도 이때예요. 보고서는 이 현상을 두고 "LLM 감각으로 '묶어서 한 번에'를 시도하는 것이 바로 버그다"라고 짚었습니다. 질문을 쪼개지 않고 뭉치면 정확도가 먼저 무너진다는 뜻이니 설계 단계에서부터 유의해야 해요.
한국어에서도 잘 작동하나요?
작동은 하지만 영어만큼은 아니에요. TypeSafe 공식 문서는 "Jev의 주 훈련 언어는 영어이며, CJK를 포함한 다른 언어도 받지만 현재 정확도가 더 낮다"라고 명시합니다. 실제로 KLUE-YNAT 실측에서 Jev의 정확도 0.760은 GPT-5.6-luna의 0.785보다 낮았지만, 지연은 269ms로 luna의 1,989ms보다 훨씬 짧았고 비용도 1,000건당 0.02달러로 luna의 0.14달러보다 저렴했습니다. confidence 0.7 이상인 80%만 Jev로 처리하고 나머지 20%를 luna에 넘기는 방식으로 섞으면, 정확도는 0.781까지 올라오면서 비용과 평균 지연은 luna 단독 대비 37% 수준으로 줄었어요. 정확도 하나만 볼 게 아니라 비용과 속도를 함께 저울질하는 편이 현실적입니다.
실무에 붙이는 방법
고객센터 사례에서는 confidence가 0.5 미만이면 사람에게, intent가 주문 조회면 코드로 DB를 조회하게, 제품 문의면 전문 LLM으로 넘기는 구조로 라우팅해요. 커뮤니티에서는 확신도 95% 이상은 자동 처리하고 70~95%는 사람이 검토하며 70% 미만은 더 큰 모델이 다시 판단하게 하는 임계값을 많이 씁니다. 보고서의 표현을 빌리면 "판단은 Jev가, 행동은 코드가, 생성은 LLM이, 계산은 도구가" 맡는 구조예요. 기존 LLM 루프 한가운데에 Jev를 끼워 넣으면 오히려 일이 늘어나니, 에이전트 루프 자체를 역할별로 다시 짜는 편이 나아요.
지금 시작하려면
typesafe.ai에서 대기 명단에 등록하면 통상 다음날쯤 승인이 나온다고 알려져 있어요. 승인 후에는 콘솔의 Playground에서 먼저 테스트해보고, Python이나 JavaScript SDK 또는 raw HTTP로 붙이면 됩니다. Vercel AI Gateway나 OpenRouter를 거쳐 연동하는 방법도 있어요. 다만 아직 독립 검증 자료가 많지 않고 초기 가격이 계속 유지된다는 보장도 없으니, 실서비스에 넣기 전에는 본인 워크로드로 직접 테스트하고 실시간 요금을 확인하는 절차를 건너뛰지 않는 게 좋습니다.
자주 묻는 질문
Jev는 ChatGPT를 대체하나요?
아니요. Jev는 글을 쓰거나 설명하지 않고 정해진 선택지 중 하나를 확률로 고르기만 합니다. ChatGPT나 Claude 같은 생성형 모델을 대체하는 게 아니라, 그 모델들이 하던 여러 업무 중 분류와 라우팅처럼 판단 위주인 부분만 떼어내 훨씬 싸고 빠르게 처리하는 역할이에요.
한국어로 써도 괜찮나요?
쓸 수는 있지만 영어보다 정확도가 낮다는 점을 감안해야 해요. KLUE-YNAT 실측에서 정확도 0.760을 기록했는데, 이는 더 비싸고 느린 모델보다는 낮은 수치입니다. confidence가 높은 구간만 자동 처리하고 나머지는 다른 모델로 넘기는 하이브리드 방식이 현실적인 대안이에요.
지금 당장 도입해야 하나요?
하루 수십만 번 이상 분류나 라우팅을 반복하는 서비스라면 0.5초와 몇 센트 차이가 비용 구조를 바꿀 만큼 커요. 반면 하루 몇백 번 수준이라면 기존 GPT나 Claude의 구조화 출력만으로도 충분합니다. 아직 얼리 액세스 단계이고 독립 검증 자료도 부족하니 급하게 서두를 이유는 없어요.
확률이 높으면 믿어도 되나요?
확률은 확신도이지 정답 인증서가 아니에요. 0.92라는 값은 "92% 확신한다"는 뜻이지 "92% 진실이다"는 뜻이 아닙니다. 같은 질문이어도 표현 방식에 따라 확률이 달라졌다는 보고도 있으니, 확률 수치 하나만으로 최종 판단을 내리기보다는 임계값과 검토 절차를 함께 설계하는 게 안전해요.
마무리
Jev는 판단을 맡고 코드는 행동을 실행하며 LLM은 생성을 담당하는 구조로 나눌 때 가장 잘 작동합니다. 도입 여부는 처리 규모와 한국어 정확도 요구 수준을 함께 보고 판단하는 게 안전해요.
여러분의 서비스에서 지금 판단에 쓰이는 시간과 비용 중, 사실은 이런 판단 전용 모델에게 넘겨도 괜찮은 부분이 얼마나 될까요?