감성 영상은 클로드 어느 모델이 잘 만들까요? 2026 클로드 모델 비교 4종 블라인드 테스트
 퀀텀점프클럽 정상록8분 읽기1 views
무료 자료
PDF · 무료
클로드 4모델 감성 영상 블라인드 비교
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
감성 영상은 클로드 어느 모델이 잘 만들까요? 2026 클로드 모델 비교 4종 블라인드 테스트
목차
- 어떻게 비교했을까요?
- 점수를 얼마나 믿어도 될까요?
- 주제별로는 어땠을까요?
- 브랜드 소개에서는 왜 의견이 갈렸을까요?
- 8주제 전체로 보면 순위가 어떻게 나왔을까요?
- 왜 비싼 모델이 총액에서는 더 쌌을까요?
- 자주 묻는 질문
- 마무리
어떻게 비교했을까요?
영상에서 확인한 조건은 단순해요. 클로드 코드 4모델에 같은 주제, 같은 프롬프트, 같은 사실 자료를 주고 1분 이내 영상을 혼자 만들게 했습니다. 클로드 코드는 순정 하네스(기본 실행 환경) 그대로 썼어요.
영상 제작은 화면을 먼저 만들고 소리를 붙이는 2단계로 진행했습니다. 사람 개입은 없었고, 대표는 영상에서 "중간에 제가 손으로 고친 건 하나도 없습니다"라고 말했어요.
| 조건 | 내용 |
|---|---|
| 모델 | 소넷 5.5, 오퍼스 5.5, 페이블 5.1, 하이쿠 5.5 |
| 주제 | 총 8개, 이번 편은 감성형 4개 |
| 완성 편수 | 31편 |
| 채점 | 제미나이 3.1 Pro가 모델 이름을 모른 채 화면만 보고 채점 |
31편인 이유는 페이블의 웨딩 영상 1편이 작업 폴더가 지워져 유실됐기 때문이에요. 그래서 웨딩 주제는 3편만 비교했습니다.
점수를 얼마나 믿어도 될까요?
제미나이 점수는 참고값이에요. 영상에서 제미나이는 화면만 봤고 소리는 평가하지 않았거든요. 영상은 소리까지 합쳐서 하나의 결과물이라서, 점수가 높다고 소리까지 좋다는 뜻은 아닙니다.
대표도 영상에서 "AI가 평가한 값이기 때문에 참고만 하시면 되겠습니다"라고 선을 그었어요. 그래서 대표가 직접 보고 매긴 평가를 따로 놓고 비교했습니다.
주제별로는 어땠을까요?
주제마다 제미나이 점수와 대표 평가를 나란히 봤어요. 아래 점수는 영상에서 공개한 값입니다.
| 주제 | 제미나이 점수 | 대표 적중 |
|---|---|---|
| 웨딩 식전영상 | 오퍼스 8, 소넷 7, 하이쿠 5 | 3편 중 3편 |
| 브이로그 | 오퍼스 9, 소넷 9, 하이쿠 6, 페이블 5 | 4편 중 4편 |
| 브랜드 소개 | 하이쿠 9, 오퍼스 7, 페이블 6, 소넷 4 | 4편 중 2편 |
| 카페 후기 | 오퍼스 9, 소넷 7, 하이쿠 6, 페이블 6 | 4편 중 4편 |
웨딩은 7년 함께한 커플이 결혼을 알리는 영상이었어요. 영상에서 제미나이와 대표 모두 사진 속 사연을 조리개로 풀어낸 구도에 감탄했습니다. 브이로그에서는 페이블이 만든 3D 남산 야경 장면이 대표를 놀라게 했어요.
브랜드 소개에서는 왜 의견이 갈렸을까요?
그릇 공방 '몽결'을 소개하는 주제였고, 로고는 원본 그대로 쓰라는 조건을 붙였어요. 제미나이는 하이쿠에 9점을 줘 1위로 올렸는데, 대표는 영상에서 "동의를 할 수가 없다"고 말하며 오퍼스를 1위로 꼽았습니다.
이 불일치는 평가 방식에서 생긴 것으로 보여요. 제미나이는 화면만 봤고 소리는 평가하지 않았거든요. 대표는 하이쿠 편을 볼 때마다 모션, 사운드, 디테일에 신경을 덜 썼다고 반복해서 짚었어요.
그래도 나머지 3주제에서는 두 평가의 1위가 같았어요. 대표는 영상에서 "제미나이가 이상하게 평가한다고 볼 순 없고 평가 기준치가 동일하다"고 정리했습니다. 뒤로 갈수록 이름 맞히기가 쉬워진 것을 두고는 "슬슬 AI 퀄리티를 저도 잘 느끼고 있는 것 같다"고 말했어요.
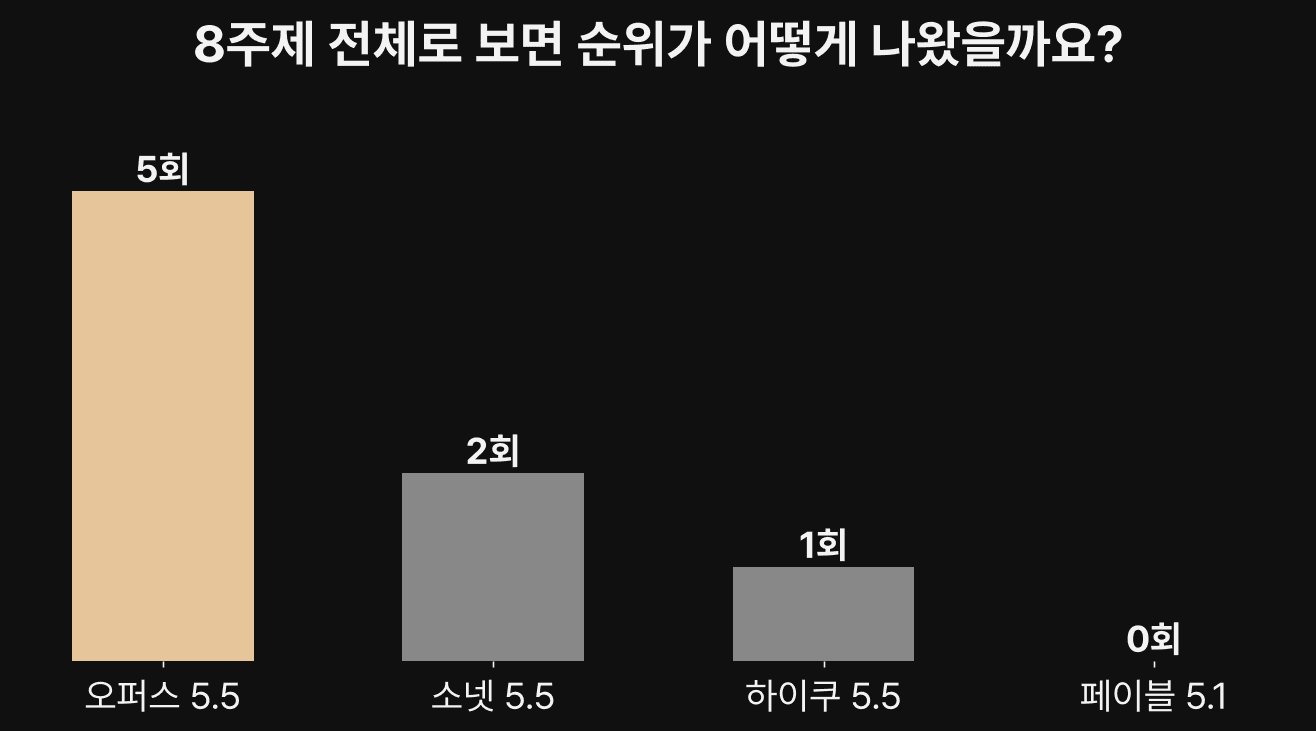
8주제 전체로 보면 순위가 어떻게 나왔을까요?
여기서부터는 이번 편의 감성형 4주제가 아니라 8주제를 합친 값이에요. 영상 요약 구간에서 공개한 수치를 그대로 옮깁니다.
8주제 전체로 보면 순위가 어떻게 나왔을까요?
자료: youtu.be · QJC 재구성
| 모델 | 화면 점수(10점 만점) | 1위 횟수 | 총 제작 시간 | 작업 턴 |
|---|---|---|---|---|
| 오퍼스 5.5 | 8.1 | 5회 | 104.2시간 | 2,935턴 |
| 소넷 5.5 | 7.4 | 2회 | 105.0시간 | 3,929턴 |
| 하이쿠 5.5 | 6.0 | 1회 | 34.4시간 | 1,919턴 |
| 페이블 5.1 | 5.7 | 0회 | 84.3시간 | 1,916턴 |
화면 점수는 제미나이 3.1 Pro가 화면만 보고 매긴 참고값이에요. 영상 끝에서 대표는 "오퍼스는 정말 압도적으로 좋습니다"라고 정리했습니다.
눈에 띄는 쪽은 페이블이에요. 공개된 백만 토큰당 단가는 네 모델 중 가장 높은데 화면 점수는 5.7점으로 꼴찌였고 1위 주제도 없었어요. 대표는 페이블과 소넷의 결과물 차이가 작았고, 소넷이 더 나은 경우도 있었다고 봤습니다.
왜 비싼 모델이 총액에서는 더 쌌을까요?
먼저 금액의 성격부터 짚을게요. 아래 금액은 전부 API 요금으로 환산한 값이고, 영상 화면에도 "실제로는 구독 요금제로 돌렸다"고 적혀 있어요. 제가 이 금액을 결제한 것은 아닙니다.
 왜 비싼 모델이 총액에서는 더 쌌을까요?
자료: 본문 데이터 · QJC 재구성
이 실험의 8주제 누적 환산액은 이렇습니다.
| 모델 | 8주제 누적 API 환산액 |
|---|---|
| 소넷 5.5 | $1,729 |
| 페이블 5.1 | $1,645 |
| 오퍼스 5.5 | $1,423 |
| 하이쿠 5.5 | $61 |
이 실험의 8주제 누적 환산액 기준으로는 오퍼스가 소넷보다 $306 적었어요. 소넷의 작업 턴이 3,929번, 오퍼스는 2,935번이었던 점이 차이를 만든 것으로 읽힙니다.
백만 토큰당 단가는 따로 봐야 해요. 공개 요금표 기준으로는 입력 오퍼스는 $4, 소넷은 $2이고, 출력 기준으로는 오퍼스 $20, 소넷 $10이라서 공식 단가는 오퍼스가 소넷의 2배입니다. 오퍼스는 이 실험에서 일을 적게 해서 총액이 낮아진 셈이에요. 두 기준을 섞어서 "오퍼스가 더 싼 모델"이라고 읽으면 틀립니다.
하이쿠의 8주제 누적 환산액은 $61이었고 총 제작 시간은 34.4시간이었어요. 대신 화면 점수는 6.0점이라서 비용을 아낀 만큼 품질에서 대가를 치렀습니다.
The New Stack 보도(Anthropic 공식 발표가 아닌 미디어 보고)에서는 에이전트 루프에서 오퍼스 5.5가 약 35% 빨리 끝났고, 15회 런을 합산하면 소넷 5.5가 42% 쌌다고 해요. 작업 성격에 따라 순위가 바뀐다는 뜻입니다.
자주 묻는 질문
감성 영상을 만들려면 어느 모델이 가장 좋았나요?
이번 편 4주제 중 3주제에서 제미나이 참고 점수 1위와 대표 평가 1위가 모두 오퍼스 5.5였어요. 8주제 전체 화면 점수도 오퍼스 5.5가 8.1점으로 가장 높았습니다. 다만 이 점수는 제미나이가 화면만 보고 매긴 참고값이에요.
영상에 나온 비용은 실제로 결제한 금액인가요?
아닙니다. 모든 금액은 API 요금으로 환산한 값이고, 실제로는 구독 요금제로 돌렸어요. 소넷 $1,729, 페이블 $1,645, 오퍼스 $1,423, 하이쿠 $61은 이 실험의 8주제 누적 환산액입니다.
제미나이 점수를 그대로 믿어도 되나요?
참고값으로만 쓰는 편이 좋아요. 제미나이는 화면만 봤고 소리는 평가하지 않았습니다. 브랜드 소개에서 하이쿠에 9점을 준 것을 대표가 받아들이지 않은 것도 이런 차이와 이어져 보여요.
사람이 중간에 손을 댔나요?
영상 기준으로 없었어요. 같은 주제와 자료를 주고 모델 혼자 화면을 만든 뒤 소리를 붙이게 했습니다. 다만 페이블의 웨딩 영상 1편은 작업 폴더가 지워져 유실돼서 총 31편이 비교 대상이에요.
하이쿠 5.5는 어떤 모델인가요?
2026-10-07 Anthropic이 공식 출시한 모델이에요. 이 실험에서는 총 제작 시간이 34.4시간이었고 화면 점수는 6.0점이었습니다.
마무리
단가표와 누적 환산액은 따로 봐야 해요. 오퍼스는 단가가 2배인데도 총액이 소넷보다 $306 적었고, 페이블은 작업 턴이 가장 적은데도 단가가 높아 총액이 2위였습니다. 화면 점수는 제미나이의 참고값이므로 소리까지 본 사람의 평가와 함께 읽는 편이 안전해요. 점수, 시간, 비용은 한 줄로 합치지 말고 각각 확인하세요.
더 보고 싶다면
모델 이름을 가린 채 맞혀 보는 전체 과정은 영상에서 확인해보세요.