Gemini 4 Carbon, Opus 5.5보다 정말 좋을까요? 항목별 비교와 가격 (2026 기준)
 퀀텀점프클럽 정상록17분 읽기0 views
무료 자료
PDF · 무료
구글의 새 AI가 순위표 맨 위에 올랐대요, 써 볼 수 있을까요?
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
Gemini 4 Carbon, Opus 5.5보다 정말 좋을까요? 항목별 비교와 가격 (2026 기준)
구글 Gemini 4 Carbon은 AA 지능 지수 v5.0에서 59점으로 1위지만 Opus 5.5(58점)와는 1점 차이고 코딩 에이전트 지수는 Opus 5.5 조합이 앞서며 일반 사용자와 개발자는 아직 쓸 수 없어요.
Gemini 4 Carbon이 1위라는데 우리도 갈아타야 하나요?
구글의 새 모델 Gemini 4 Carbon은 독립 평가에서 1위가 맞아요. 다만 모든 항목에서 Anthropic의 Claude Opus 5.5를 앞서는 건 아니고 2026-10-30 기준 누구나 쓸 수 있는 모델도 아닙니다.
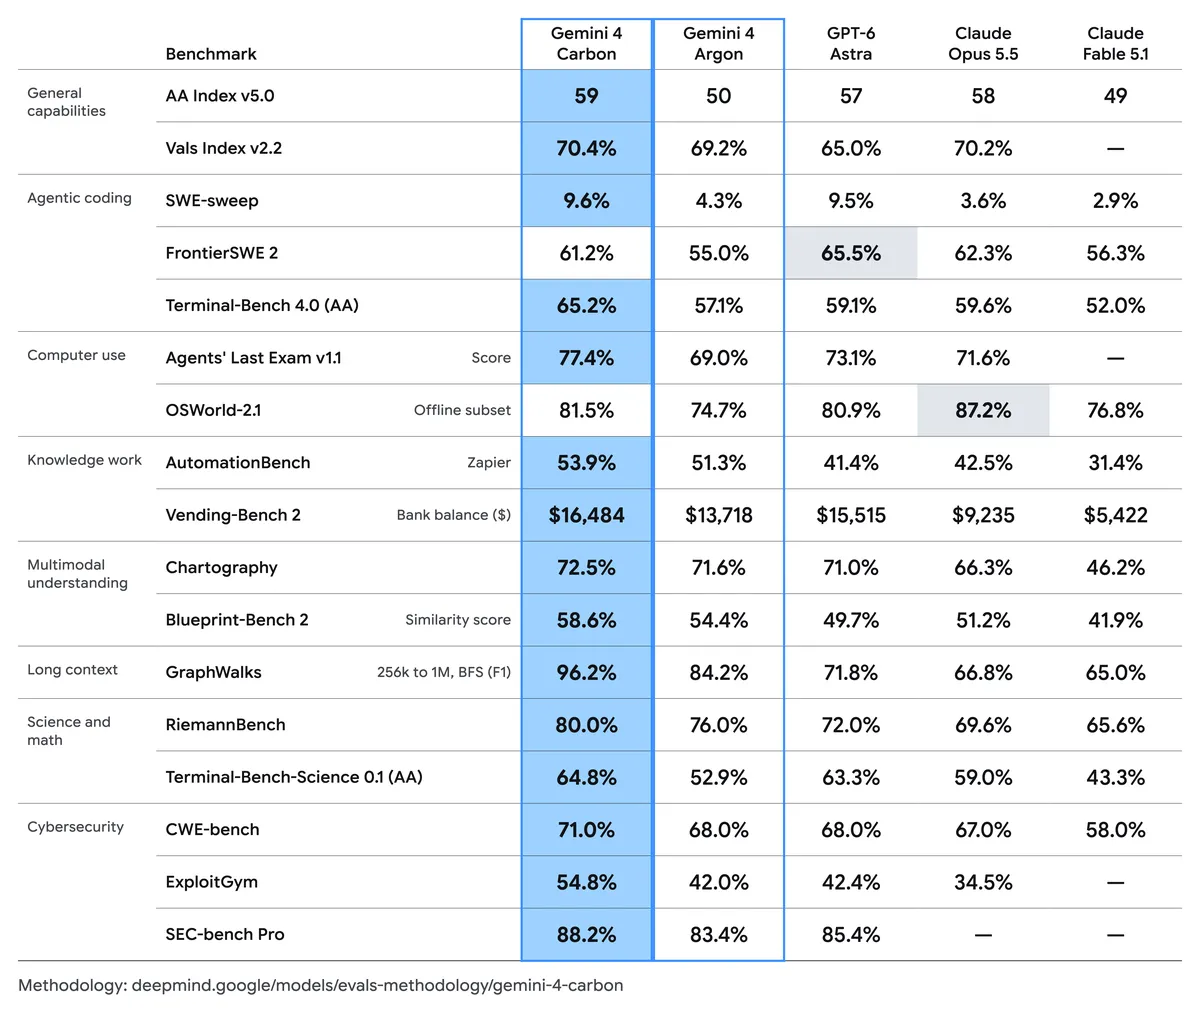
Gemini 4 Carbon benchmark table
이미지 출처: blog.google
"벤치마크 1위라는데 우리 팀이 쓰는 모델도 바꿔야 하나요?" 이런 질문이 먼저 떠오르실 거예요. 숫자만 보면 바꾸고 싶다가도 못 쓰는 모델이라는 말에 멈칫하게 되죠. 그 망설임은 자연스럽습니다. 이 글은 1위의 범위, Opus 5.5와 맞붙은 항목, 며칠씩 일한다는 주장의 근거, 가격, 한국에서의 이용 가능 여부, 지금 해 둘 준비 순서로 답해요.
한 줄 답: Gemini 4 Carbon은 AA 지능 지수 v5.0에서 59점으로 1위지만 Opus 5.5(58점)와는 1점 차이예요. 9개 평가 중 1위는 4개이고 코딩 에이전트 지수는 Opus 5.5 조합(62점)이 Carbon 조합(59점)보다 3점 앞서요. 도입가는 100만 토큰당 입력 $2, 출력 $10이지만 API에는 아직 없어요.
구글은 2026년 10월 28일(미국 시각), 한국 시각으로 10월 29일 새벽에 블로그 글 "Gemini 4 Carbon: our next frontier model"을 올렸어요. 구글은 이 모델을 "our strongest model with state-of-the-art cybersecurity and long horizon capabilities"라고 소개했습니다. 작성자는 Koray Kavukcuoglu(구글 딥마인드 SVP 겸 구글 Chief AI Architect)예요.
이 글의 수치는 구글 블로그와 5쪽짜리 평가 방법론 PDF, Artificial Analysis 리더보드(2026-10-30 접속)에서 가져왔어요. Carbon 전용 모델 카드는 2026-10-30 시점에 찾지 못했습니다. 공식 근거는 블로그 본문과 방법론 PDF 두 가지뿐이에요.
속도도 화제였어요. Sundar Pichai는 X에서 Argon 일반 출시 이후의 간격을 강조했는데 구글 원문이 말한 "2주"는 Argon 일반 출시일(2026-10-13) 기준이에요. 그날부터 Carbon 발표일(2026-10-28)까지는 15일이고 Argon 발표일(2026-09-30)부터 세면 28일입니다.
AA 지능 지수 1위는 어디까지 믿어도 되나요?
AA 지능 지수(Intelligence Index)는 독립 AI 평가 기관 Artificial Analysis(AA)가 여러 평가를 묶어 매기는 종합 점수예요. 구글의 방법론 PDF는 "AA Index v5.0 (with tools) results are sourced from the Artificial Analysis Intelligence Index."라고 적었습니다. 구글이 직접 잰 값이 아니라 AA 값을 옮겼다는 뜻이에요.
AA 리더보드(2026-10-30 접속)에 따르면 Carbon(High)은 59.43점이에요. Claude Opus 5.5(Max)는 58.41점, GPT-6 Astra(Max)는 56.85점, Gemini 4 Argon(High)은 50.41점입니다. 구글 발표 표의 59, 58, 57, 50과 반올림 기준으로 모두 같아요. 모델 단위로 묶으면 2위가 Opus 5.5, 3위가 GPT-6 Astra예요. 1위와 2위의 차이는 반올림 기준 1점(Opus 5.5 58점 대비 Carbon 59점)입니다.
범위 제한은 AA가 직접 달았어요. AA는 "it is not leading in all these areas"라고 적었고 9개 평가 중 Carbon이 1위인 것은 HLE-Diamond, Terminal-Bench-Science, AA-Omniscience, AutomationBench-AA 4개예요. 코딩과 지식 업무에서는 1위가 아니라는 설명이죠. v5.0은 9개 평가로 새로 구성된 버전이라 이전 버전 점수와 직접 비교하면 안 됩니다.
"AI가 틀린 말을 하면 어떡하죠?" 하는 걱정에는 AA-Omniscience 환각률이 참고가 돼요. 낮을수록 좋은 값인데 AA 측정으로 Carbon은 11%, Argon은 4%, Opus 5.5(Max)와 GPT-6 Astra(Max)는 각각 50%예요. Argon 4% 대비로는 올랐고 두 경쟁 모델 50%보다는 낮습니다.
Opus 5.5를 넘었다는 말은 어느 항목에서 맞나요?
구글 블로그의 비교표에서 Carbon과 Opus 5.5만 뽑았어요. 아래 차이는 모두 Opus 5.5 대비 %p입니다. 구글 표에는 경쟁 모델이 4개만 들어 있어서 표에 없는 모델과는 비교되지 않아요.
| 벤치마크 | Carbon | Opus 5.5 | Opus 5.5 대비 |
|---|---|---|---|
| Terminal-Bench 4.0 (AA 측정) | 65.2% | 59.6% | +5.6%p |
| Terminal-Bench-Science 0.1 (AA 측정) | 64.8% | 59.0% | +5.8%p |
| Agents' Last Exam v1.1 | 77.4% | 71.6% | +5.8%p |
| AutomationBench (Zapier) | 53.9% | 42.5% | +11.4%p |
| GraphWalks (256k~1M 토큰) | 96.2% | 66.8% | +29.4%p |
| SWE-sweep | 9.6% | 3.6% | +6.0%p |
| Vals Index v2.2 | 70.4% | 70.2% | +0.2%p |
| FrontierSWE 2 | 61.2% | 62.3% | -1.1%p |
| OSWorld-2.1 (offline subset) | 81.5% | 87.2% | -5.7%p |
마지막 두 줄은 Opus 5.5가 앞서는 항목이에요. FrontierSWE 2의 1위는 GPT-6 Astra(65.5%)이고 Vals Index v2.2의 1위는 표에 없는 Claude Sonnet 5.5(70.85%)입니다. Agents' Last Exam, SWE-sweep, OSWorld-2.1의 Carbon 값은 구글이 직접 계산한 값이에요.
가장 자주 섞이는 숫자가 Terminal-Bench 4.0이에요. Carbon 65.2%는 Argon(57.1%) 대비로는 8.1%p 높지만 Opus 5.5 대비로는 5.6%p예요. "Opus 5.5보다 8점 높다"는 문장은 기준선이 틀린 거예요. 같은 AA 표에서 Kimi K3.1 Pro는 67.2%로 Carbon보다 높습니다.
측정 방식이 바뀌면 순서도 바뀌어요.
- AA 코딩 에이전트 지수(모델과 도구를 함께 측정): Claude Code와 Opus 5.5(Max) 조합이 62점, Antigravity CLI와 Carbon(High) 조합이 59점으로 Opus 5.5 조합이 3점 앞서요.
- AA FrontierCode 2.0: Opus 5.5(Max) 46.4%, Carbon 40.6%예요.
- Vals AI 자체 측정: Terminal-Bench 4.0에서 Carbon은 63.13%로 57개 모델 중 4위입니다.
- Arena 공식 X에 따르면 Carbon(High)은 Text Arena 1위, Agent Arena 2위, WebDev 4위예요. 구글은 WebDev에서 "jumps +89 elo points to land at #4 (1768)"라고 적었지만 +89의 기준선은 밝히지 않았어요.
며칠씩 일한다는 주장에는 근거가 있나요?
구글 블로그에는 이런 문장이 있어요. "Internally, our teams have seen Carbon run for days to persist through dead ends" 이어서 큰 코드베이스에서 미묘한 버그의 근본 원인을 찾아 고치는 작업을 예로 들었습니다.
이건 구글 내부 팀의 관찰 서술이에요. 실행 시간 분포, 성공률, 사례 수, 실행 조건이 원문에 없고 방법론 PDF에도 이 주장과 대응하는 측정 항목이 없어요. 그래서 "구글은 Carbon이 며칠씩 이어서 일하는 것을 봤다고 밝혔다" 정도로만 읽는 게 안전합니다. 관련 있는 공개 측정은 GraphWalks 96.2%(256k~1M 토큰)와, 방법론 PDF에 5시간 창으로 잰다고 적힌 Agents' Last Exam v1.1 77.4%예요. "며칠"을 직접 재는 공개 벤치마크는 원문에 없습니다.
구글이 같은 글에서 제시한 안전·신뢰성 수치도 대부분 구글 내부 측정이에요.
- 근거 없는 주장(unsupported claims): Argon 대비 약 2배 감소
- 간접 프롬프트 인젝션(Gray Swan) 공격 성공률: Argon 0.7%에서 Carbon 0.0%
- Terminal-Bench 4.0 부정행위 성공률 0.0%, 시도율 0.4%(비교 기준 미표기)
- overreach 26%, under-service 29% 감소: 무엇 대비인지 측정 방법이 원문에 없는, 기준선을 밝히지 않은 회사 주장
사이버 방어 벤치마크는 점수 수준까지만 볼게요. 구글 표에서 SEC-bench Pro는 Carbon 88.2%, Argon 83.4%이고 CWE-bench는 Collinear AI 공개 리더보드 기준 Carbon 71.0%, Argon 68.0%예요. 구글은 이 평가가 "evaluated without guardrails"라고 단서를 달았고 구글 자체 계산 값은 독립 재현이 확인되지 않았습니다.
가격은 Opus 5.5나 GPT-6 Astra와 비교하면 어떤가요?
구글 블로그에 따르면 Carbon의 도입가는 100만 토큰당 입력 $2, 출력 $10이고 캐시 입력은 입력가의 95% 할인이에요. 구글은 "Gemini 4 Carbon will launch at the same introductory price as Argon at $2 per million input tokens and $10 per million output tokens"라고 밝혔습니다. 도입 기간이 끝나면 $4/$20이에요.
| 모델 | 입력 | 출력 | 조건 |
|---|---|---|---|
| Gemini 4 Carbon 도입가 | $2 | $10 | 종료일 미공개 |
| Gemini 4 Carbon 도입 기간 뒤 | $4 | $20 | 구글 블로그 각주 |
| Gemini 4 Argon | $2 → $4 | $10 → $20 | 2026-11-30까지 도입가, 2026-12-01부터 정가 |
| Claude Opus 5.5 | $4 | $20 | Anthropic 가격 페이지 |
| GPT-6 Astra | $10 | $50 | OpenAI 가격 페이지 |
| GPT-6.1 Terra | $1 | $5 | OpenAI 가격 페이지 |
단위는 100만 토큰당 USD이고 표준 요금이에요. Carbon 외 가격은 각사 공식 가격 페이지(2026-10-30 접속)에서 가져왔습니다.
기준선별로 나눠 보면 이래요. Opus 5.5 정가 대비로 Carbon 도입가는 절반이고 도입 기간 뒤 정가는 같아요. GPT-6 Astra 정가 대비로는 도입가가 1/5, 도입 기간 뒤 정가가 2/5예요. 반대로 GPT-6.1 Terra 정가 대비로는 도입가가 2배, 도입 기간 뒤 정가가 4배입니다.
"단가가 싸면 실제 청구액도 낮을까요?" 이 질문에는 토큰 사용량이 답해요. AA 측정에서 Carbon은 지수 전체를 돌리는 데 토큰 2억 개를 썼고 AA 전체 모델 중앙값(7,100만 개) 대비 많은 양이에요. 반면 Opus 5.5(Max) 대비로는 과제당 출력 토큰이 29% 적어요(123k 대 173k). AA가 정가($4/$20) 기준으로 계산한 과제당 비용은 Carbon $7.76이에요. Opus 5.5(Max)의 $10.04 대비 약 23% 낮고 GPT-6 Astra(Max)의 $6.25 대비 약 1.2배입니다.
도입가 구간의 청구액은 같은 사용량이면 정가 구간의 절반이에요. 다만 도입 기간 종료일은 Carbon 글에 없어요. Argon의 2026-11-30을 Carbon에 그대로 옮겨 계산하면 안 됩니다.
한국에서 지금 쓸 수 있나요?
한국을 포함해 전 세계 일반 사용자와 개발자가 아직 Carbon을 쓸 수 없어요. 한국만 막힌 게 아니라 아직 공개되지 않은 모델이에요. Gemini API 이용 가능 국가 목록(2026-10-22 갱신)에는 South Korea가 있지만 Gemini API 가격 페이지, 모델 목록, 변경 이력 어디에도 Carbon이 없습니다. 세 페이지 모두 2026-10-28 UTC에 갱신됐고 2026-10-30에 확인했어요. 공식 모델 ID도 공개되지 않았습니다.
구글 블로그가 밝힌 순서는 이래요. 발표 주부터 사이버 방어자 일부에게 제공하고 Fairwind Program으로 신뢰 파트너를 넓혀요. 그다음 가드레일을 개선한 뒤 개발자와 기업과 소비자에게 내놓는다고 했는데 날짜는 적혀 있지 않아요. Gemini 앱에도 없습니다. Argon은 2026-10-13 일반 출시 때 Gemini 앱(Google AI Ultra·Pro 구독자)과 검색 AI Mode에 들어갔지만 Carbon은 그렇지 않아요.
Fairwind Program 페이지는 "over 650 partners globally"라고 적고 있어요. 하지만 대상은 정부와 국가 사이버 당국, 핵심 기반시설 운영자, 핵심 기술 플랫폼이고 신청은 Google Cloud 계정 팀을 통해 합니다. 일반 개발자용 대기 신청 경로는 공식 문서에서 찾지 못했어요.
개발자 커뮤니티 반응도 갈렸어요. Hacker News의 두 스레드(998 points, 324 points)에서 $2/$10 도입가에는 관심이 컸고, 두 번째 스레드에는 "a frontier model that nobody can actually use"라는 표현과 함께 미공개 모델에 1위를 주면 안 된다는 비판이 올라왔어요. 커뮤니티 글은 분위기를 볼 참고일 뿐 사실 근거는 아닙니다.
일반 공개 전에 무엇을 준비하면 되나요?
공식 문서에 근거한 준비는 다섯 가지예요. 평가 세트 없이 모델부터 바꾸면 무엇이 좋아졌는지 판단할 기준이 없습니다.
- Argon으로 평가 세트부터 만드세요. Argon(gemini-4-argon)은 2026-10-13부터 한국에서도 유료 API로 쓸 수 있고 Carbon 도입가와 같은 $2/$10이에요. 무료 등급은 없어요. 자사 업무 과제 20~50개를 모아 두면 Carbon API가 열리는 날 모델 이름만 바꿔 비교할 수 있습니다.
- 가격은 두 구간으로 따로 계산하세요. $2/$10과 $4/$20을 나눠서 보세요. Argon 도입가는 2026-11-30에 끝나고 2026-12-01부터 $4/$20이에요. Carbon이 AA 전체 중앙값 대비 토큰을 많이 쓴다는 AA 관찰을 반영해 출력 단가 쪽 민감도도 확인해 두면 좋아요.
- 비교 상대를 용도별로 정하세요. 코딩 에이전트라면 Claude Code와 Opus 5.5 조합, 비용이 중요하다면 GPT-6.1 Terra($1/$5)를 넣어요.
- 대기 신청 경로는 없다고 보세요. Gemini API 변경 이력과 Gemini API 가격 페이지를 확인 대상으로 두는 정도가 현실적입니다.
- 보안팀이라면 대안 경로를 보세요. Fairwind 페이지 FAQ는 자격이 없는 조직에 "CodeMender with publicly available models"를 안내해요.
마무리
Carbon의 1위는 사실이지만 범위가 있어요. AA 지능 지수 v5.0 안에서 Opus 5.5(58점)보다 1점 높고 9개 평가 중 4개에서만 1위입니다. 코딩 에이전트 지수와 OSWorld-2.1은 Opus 5.5가 앞서요. 며칠씩 일한다는 이야기는 구글 내부 관찰이고 API는 2026-10-30 접속 기준 어디에도 없어요.
우리 팀 상황에 맞는지부터 따져보셔도 충분해요. 판단에 필요한 기준은 위에 정리해 뒀습니다. 지금 쓰는 모델에서 가장 아쉬운 업무 하나를 꼽는다면, 그 업무로 Carbon이 열리는 날 바로 비교해 볼 준비가 되어 있나요?
자주 묻는 질문
Gemini 4 Carbon을 지금 API나 앱에서 쓸 수 있나요?
아니요. 2026-10-30 접속 기준 Gemini API 가격 페이지, 모델 목록, 변경 이력에 Carbon이 없고 Gemini 앱에도 들어가지 않았어요. 구글은 사이버 방어자 일부, Fairwind Program 파트너, 개발자·기업·소비자 순서로 넓힌다고 했지만 날짜는 적지 않았습니다.
Carbon이 Opus 5.5보다 코딩을 더 잘하나요?
측정 방법에 따라 달라요. Terminal-Bench 4.0(AA 측정)은 Carbon 65.2%로 Opus 5.5 59.6% 대비 5.6%p 높지만 AA 코딩 에이전트 지수는 Claude Code와 Opus 5.5 조합이 62점으로 Antigravity CLI와 Carbon 조합 59점보다 3점 앞서요. FrontierSWE 2에서도 Opus 5.5(62.3%)가 Carbon(61.2%)보다 높습니다.
토큰 단가가 싸면 실제 비용도 낮아지나요?
기준선에 따라 달라요. AA가 정가 $4/$20 기준으로 계산한 과제당 비용은 Carbon $7.76으로 Opus 5.5(Max) $10.04 대비 약 23% 낮지만 GPT-6 Astra(Max) $6.25 대비로는 약 1.2배예요. 다만 지수 전체에서 토큰 2억 개를 써서 AA 전체 모델 중앙값(7,100만 개) 대비 많이 쓰는 편이니 자사 업무로 직접 재 봐야 합니다.
대기 신청은 어디서 하나요?
일반 개발자용 대기 신청의 공식 경로는 없어요. Fairwind Program은 정부, 핵심 기반시설, 핵심 기술 플랫폼 대상이고 Google Cloud 계정 팀을 통해 신청해요. 해당하지 않으면 Gemini API 변경 이력과 가격 페이지를 확인해 두는 게 좋습니다.
Argon으로 먼저 준비해도 의미가 있나요?
네, 있어요. Argon(gemini-4-argon)은 2026-10-13부터 한국에서 유료 API로 쓸 수 있고 도입가가 Carbon과 같은 $2/$10이에요. 평가 세트를 만들어 두면 Carbon API가 열릴 때 모델 이름만 바꿔 비교할 수 있습니다. 단 Argon 도입가는 2026-11-30에 끝나요.
참고 자료
- Google 공식 블로그: Gemini 4 Carbon: our next frontier model
- Artificial Analysis: Gemini 4 Carbon is the new #1 on the Artificial Analysis Intelligence Index v5
- Artificial Analysis Intelligence Index v5.0 리더보드
- Gemini API 공식 가격 페이지
- Gemini API Release notes
- Google DeepMind Fairwind Program
- Anthropic 공식 Claude API 가격 페이지
- OpenAI 공식 API 가격 페이지