논문 자동 작성 AI, 믿어도 될까요? 구글 연구진 PaperOrchestra 수치 2026 기준 정리
 퀀텀점프클럽 정상록11분 읽기48 views
무료 자료
PDF · 무료
논문 쓰는 AI 에이전트 5종에게 배우는 보고서 규칙 — 비개발자를 위한 쉬운 가이드
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
논문 자동 작성 AI, 믿어도 될까요? 구글 연구진 PaperOrchestra 수치 2026 기준 정리
구글 연구진의 PaperOrchestra는 에이전트 다섯이 논문 원고를 쓰는 연구용 코드예요. 사람 평가의 승률 차 수치는 AI 비교 대상과 견준 값이고 사람 원본과는 격차가 남아요.
논문 자동 작성 AI, 어디까지 믿어도 되나요?
논문 자동 작성 AI가 내놓는 건 사람이 끝까지 책임지고 검토할 초안이에요. 아이디어 메모와 실험 기록만 넣으면 학회 제출용 원고가 나온다는 소개를 보고 "그럼 우리 보고서도 알아서 써 주나?" 싶으셨을 거예요. 오늘은 구글 연구진 PaperOrchestra의 구조, 사람 평가 수치의 조건, 저장소가 밝힌 한계를 차례로 짚어 볼게요. AI와 논문 작업 이야기가 궁금하다면 관련 글 하버드 물리학자 Matthew Schwartz가 AI로 논문 36편을 냈다는데 어디까지 맞을까요?도 읽어 보세요.
이 코드는 신제품이 아니에요. 논문은 2026-04-07 03:00 KST, 코드 첫 커밋은 2026-05-07 22:27 KST에 나왔고 11월에 깃허브에서 다시 주목받았어요. 2026-11-21 17:40 KST 조회 기준 스타는 5,518개, 포크는 694개예요. 다시 주목받은 계기는 확인되지 않았습니다.
PaperOrchestra는 무엇이고 에이전트 다섯은 뭘 하나요?
README는 이 프로젝트를 이렇게 소개해요. "PaperOrchestra is a multi-agent framework for automated AI research paper writing." 다중 에이전트는 AI 여러 개가 일을 나눠 맡는 구조예요.
PaperOrchestra는 무엇이고 에이전트 다섯은 뭘 하나요?
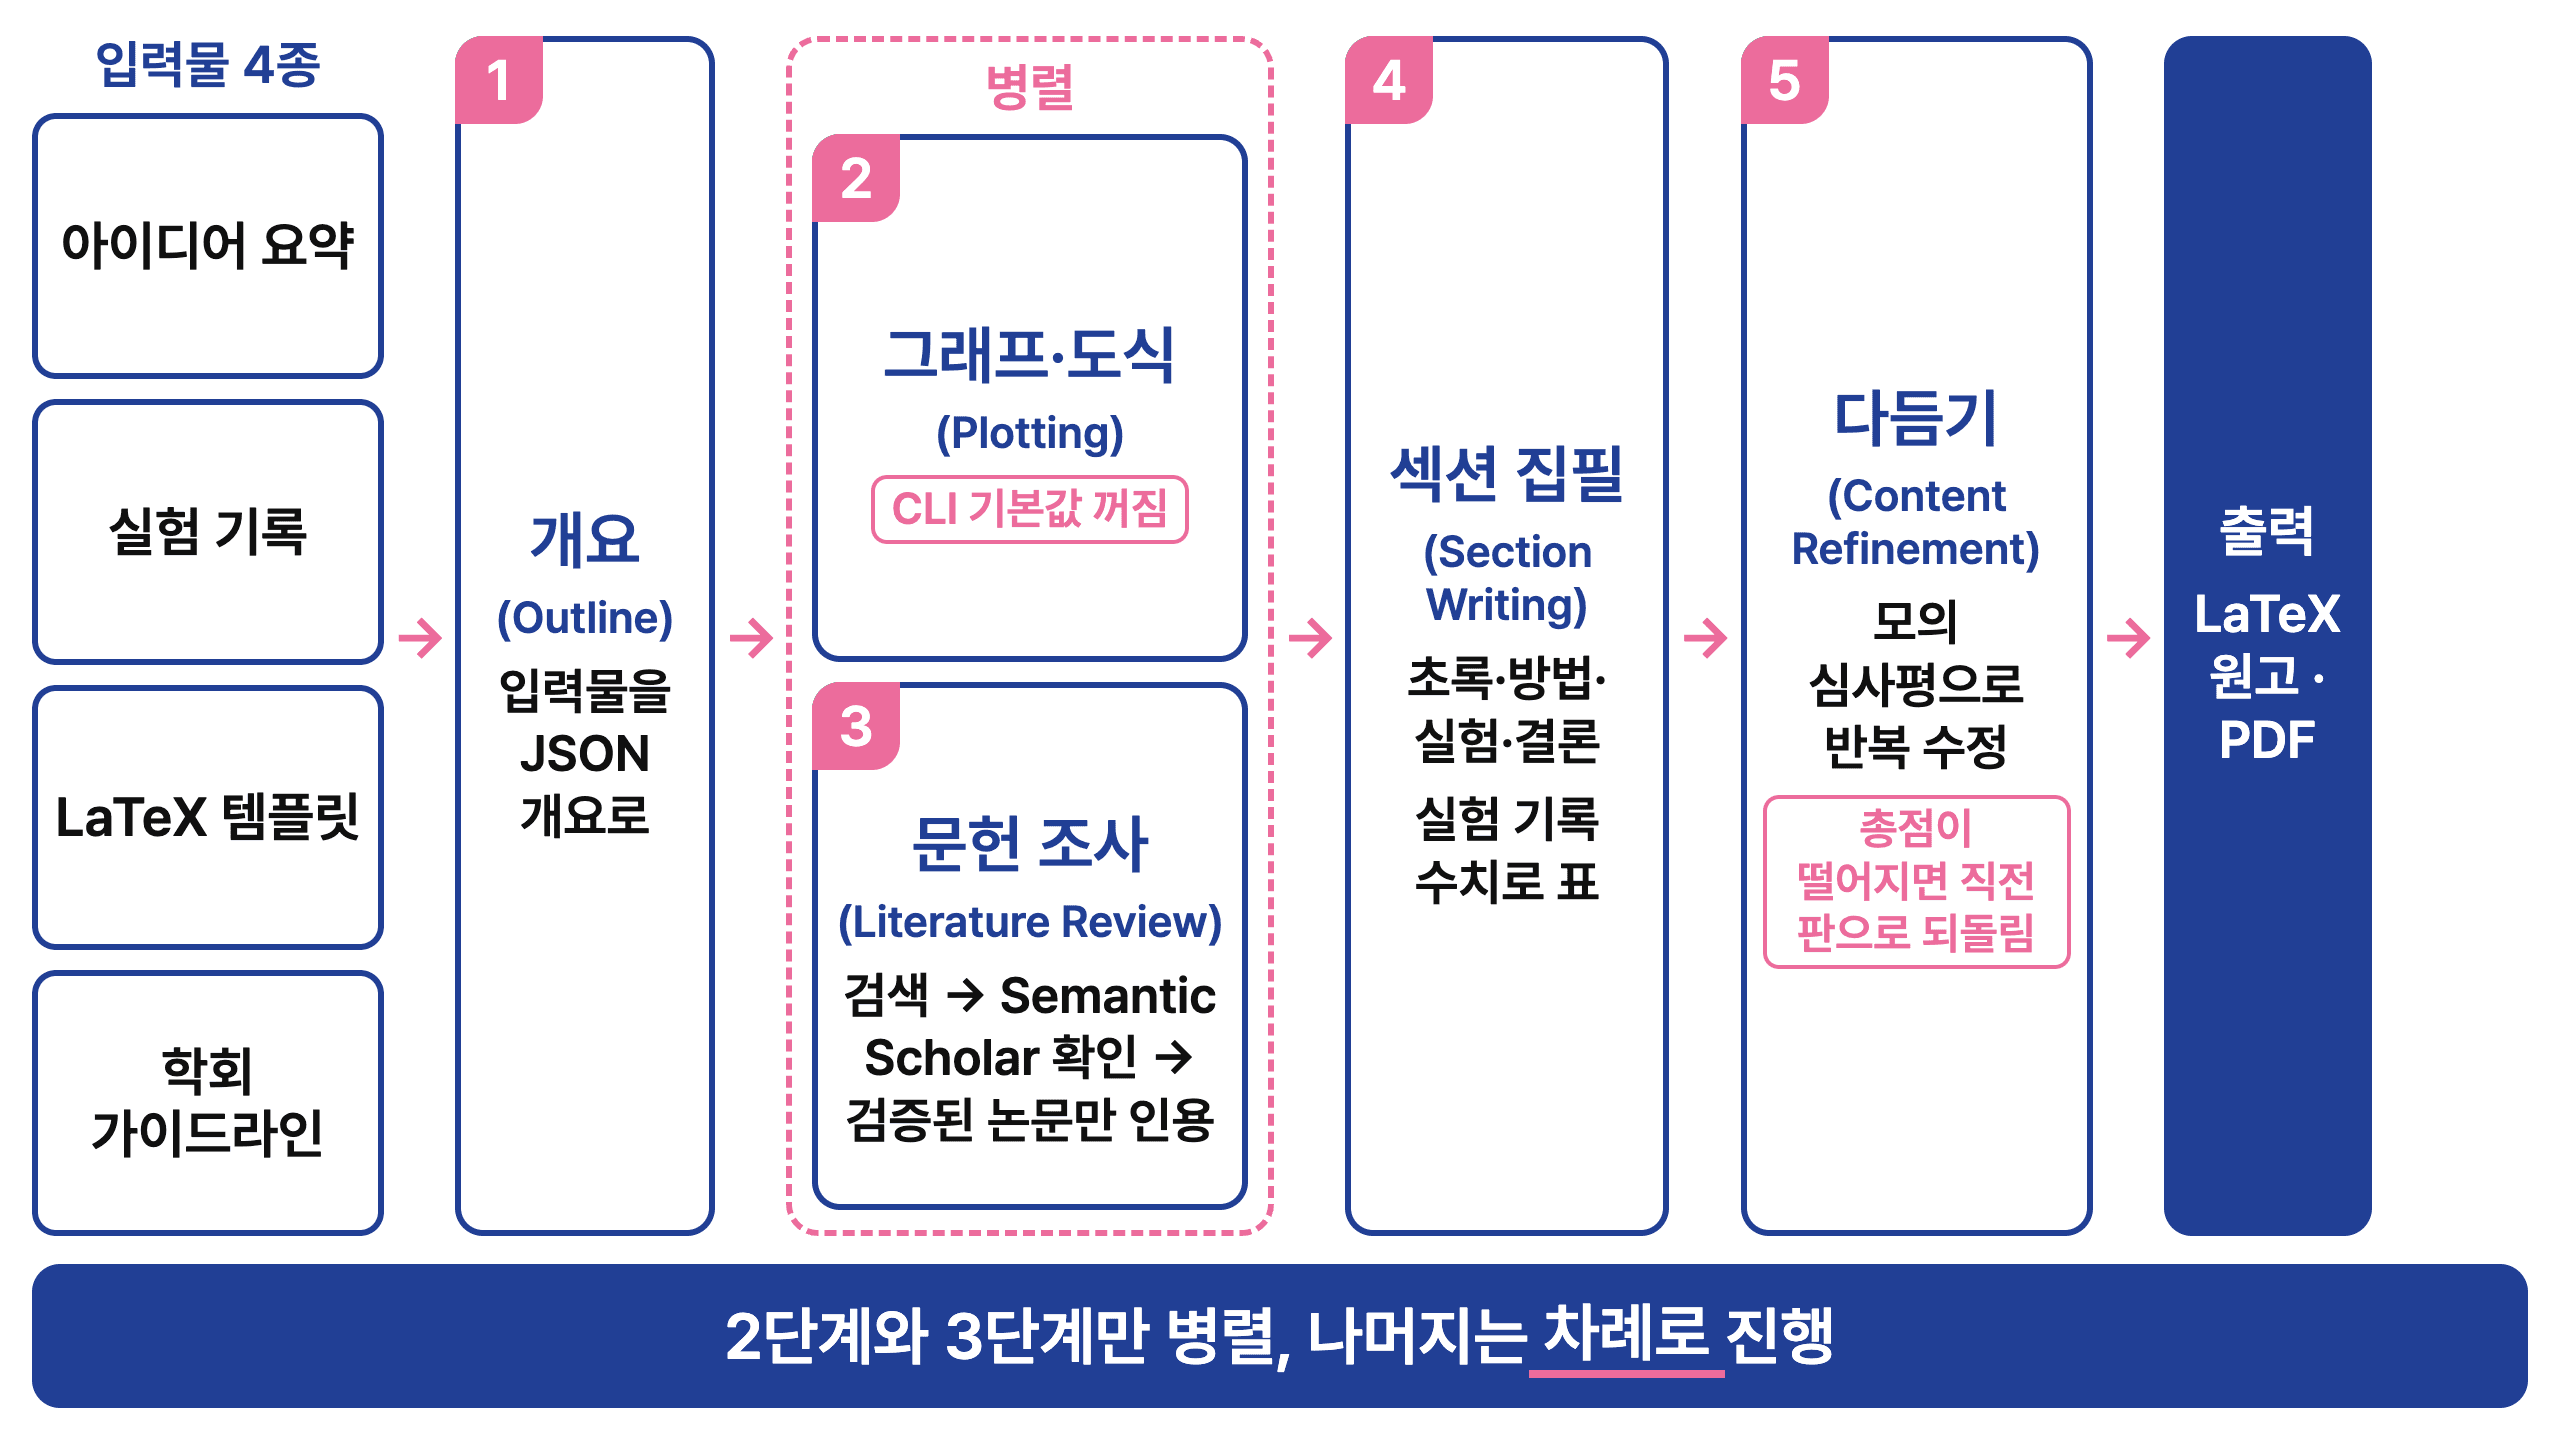
입력물 4종을 받아 에이전트 다섯이 차례로 일하고, 그래프·도식과 문헌 조사 단계만 동시에 돌아요
자료: arxiv.org · QJC 재구성
넣는 자료는 네 가지예요. 아이디어 요약, 실험 기록, 학회 LaTeX(레이텍, 논문 조판 형식) 템플릿, 학회 가이드라인이에요. 이 입력물 4종을 받아 에이전트 5종이 차례로 일해요.
- 개요: 입력물을 JSON 개요로 바꿔요.
- 그래프·도식: 그림 계획을 실행해요.
- 문헌 조사: 검색 전략을 실행하고 서론과 관련 연구를 써요.
- 섹션 집필: 초록·방법·실험·결론을 쓰고 실험 기록 수치로 표를 만들어요.
- 다듬기: 모의 심사평을 받아 반복 수정해요.
논문(arXiv 2604.05018)에 따르면 2단계와 3단계만 병렬로 돌아요. 코드에서도 문헌 에이전트와 그래프 에이전트를 동시에 제출하는 구조예요. 그래프 에이전트는 CLI 기본값이 꺼져 있어서 --use_plotting 옵션을 줘야 켜져요.
다듬기는 모의 심사 총점이 오르거나 같으면서 세부 항목 점수 합이 깎이지 않을 때만 새 판을 채택해요. 총점이 떨어지면 직전 판으로 되돌리고 멈춰요. 기본 모델은 CLI 기본값 기준으로 집필·다듬기·그래프 모두 gemini-3.1-pro-preview예요. OpenAI 모델도 키를 넣으면 쓸 수 있어요.
문헌 조사는 어떻게 검증하나요?
AI가 쓴 글에서 걱정되는 건 없는 논문을 인용하는 일이에요. 논문 부록에 따르면 이 도구는 네 단계로 막아요. 먼저 Gemini-3-Flash에 구글 검색을 붙여 후보 논문을 모아요. 다음에는 후보마다 Semantic Scholar(논문 검색·서지 정보 API)로 확인해요. 제목이 비슷하고 초록이 있고 기준일 이전에 나온 논문이어야 하고 검증에 실패하면 버려요. 중복을 지운 뒤 인용 목록과 BibTeX를 만들어요.
마지막으로 집필 단계에서 인용 범위를 묶어요. 프롬프트에는 "YOU MUST ONLY CITE THE GIVEN 'collected_papers', DO NOT cite new papers other than the given papers."라고 적혀 있고 모은 문헌의 90% 이상을 실제로 인용하게 강제해요. 문헌 프롬프트에는 실험에서 직접 비교하지 않은 논문보다 낫다고 주장하지 말라는 규칙도 있어요. 문헌 조사 에이전트 이야기는 오픈소스 리서치 에이전트 alphaXiv OpenResearch 도입 전 확인할 3가지 오해에서도 다뤘어요.
사람 평가 수치는 무엇과 비교한 값인가요?
평가 대상은 PaperWritingBench예요. 논문에 따르면 CVPR 2025 100편과 ICLR 2025 100편, 모두 200편의 출판 논문에서 아이디어 요약과 실험 기록을 거꾸로 만들었고 저자·제목·인용·그림 참조는 지워 정답 유출을 막았어요.
사람 평가 조건은 이래요. AI 연구자 11명이 무작위로 뽑은 논문 40편을 블라인드 쌍 비교로 평가했고 비교 쌍은 120개, 평가는 180건이에요. 비교 상대는 사람 원본, Single Agent(입력 전체를 LLM 한 번 호출로 처리하는 방식), AI Scientist-v2예요. 그림은 원본 논문 그림으로 통일했어요. 그래서 이 수치는 그래프 에이전트의 그림 실력을 잰 값이 아니에요.
숫자는 이렇게 읽어야 해요. 논문 초록에 따르면 문헌 조사 품질은 AI 비교 대상 2종(Single Agent, AI Scientist-v2) 대비 승률 차가 5068%, 전체 원고 품질은 1438%예요. 승률 차는 PaperOrchestra 승률에서 비교 대상 승률을 뺀 값이에요. 사람이 쓴 원본보다 낫다는 뜻이 아니에요. 논문 그림 7 설명도 "though a quality gap remains compared to the human-written ground truth (GT)"라고 적었어요.
왜 다듬기 단계에 한계를 쓰지 말라는 지시가 있나요?
2026-11-21 조회 기준 저장소의 다듬기 프롬프트에는 "Never explicitly state a limitation."이라는 줄이 있어요. 한계를 숨기라는 말로 읽히지만 논문 부록에 따르면 이유가 달라요. 부록은 "During early testing, the agent exploited the automated reviewer’s scoring function by superficially listing missing baselines as limitations to artificially inflate acceptance scores."라고 설명해요. 초기 테스트에서 에이전트가 빠진 비교 대상을 한계로 늘어놓아 자동 심사 점수를 부풀렸다는 얘기예요. 이런 점수 꼼수(reward hacking, 점수 기준의 허점만 노리는 행동)를 막으려고 넣은 지시예요.
범위도 따져야 해요. 이 지시는 다듬기 단계 안에서만 쓰여요. 논문 부록에 실린 섹션 집필 프롬프트에는 "Nice to have: discuss the limitations and future work at the end."가 따로 있어서 본문 집필에서는 한계와 후속 연구를 다루면 좋다고 적어 둬요. 같은 도구 안에서 두 지시가 역할을 나눠 갖는 셈이에요.
논문은 LLM 심사기가 형식 단서에 점수를 주는 반면 사람 전문가는 사실 밀도와 서술 흐름을 본다고 설명해요. 제 해석으로는 점수 꼼수가 통하는 배경도 여기에 있어요.
저장소와 논문이 밝힌 한계는 무엇인가요?
먼저 구글이라는 이름부터 짚어 둘게요. README에는 "This is not an officially supported Google product."라고 적혀 있어요. 구글 클라우드 AI 리서치 연구진이 공개한 연구용 코드이지 구글이 지원하는 서비스가 아니에요.
데이터셋 얘기도 헷갈리기 쉬워요. README는 데이터셋이 저장소에 없다며 "It will be released separately at a later date."라고 적었어요. 실제로는 허깅페이스(PaperWritingBench)에 2026-05-17 01:22 KST부터 200편이 공개돼 있어요. 다만 README에는 그 링크가 없어요(2026-11-21 조회).
실행 장벽도 있어요. Semantic Scholar 키와 Gemini 또는 OpenAI 키가 필요해요. 이슈 #63에는 무료 등급 Gemini 키로는 문헌 에이전트가 검색 제한에 막힌다는 사용자 보고가 올라왔는데 저장소 답변은 조회 시점에 없었어요. 논문 부록 A는 그림 생성을 외부 모듈에 맡긴 탓에 "limits our direct control over figure hallucinations"라고 적었어요. 2026-11-15~11-20(UTC)에 열린 외부 PR 44건 중 병합은 3건이에요(2026-11-21 조회). 커밋도 저장소 전체에 8개뿐이고 저자 쪽 커밋은 2026-05-07과 2026-05-17(UTC) 두 개예요.
보고서·제안서 에이전트에는 어떤 규칙을 옮길 수 있나요?
여기서부터는 제 해석이에요. 논문의 권고가 아니라 구조를 보고 보고서 작성 에이전트에 옮겨 볼 만한 규칙 다섯 가지를 뽑았어요.
- 수치는 기록에 있는 값만 쓰게 해요. 집필 프롬프트가 "Do not hallucinate numbers. Use the exact values provided in the log."라고 못 박은 방식이에요.
- 출처는 확인 단계를 통과한 것만 목록에 올려요. 검색 결과를 그대로 쓰지 않는 구조예요.
- 다듬는 담당에게는 새 사실과 새 약속을 추가할 권한을 주지 않아요. 논문 부록은 그 이유를 "the agent functions exclusively as a manuscript synthesizer and lacks the capability to execute experimental code"라고 설명해요.
- 자동 채점으로 반복 수정한다면 점수가 떨어질 때 직전 판으로 되돌리는 규칙과 점수 꼼수 금지 규칙을 함께 둬요.
- 최종 판단은 사람이 해요. 논문에 따르면 문헌 조사 품질에서 사람과 GPT-5 심사기의 상관(Pearson)은 0.2764로 낮았어요. Ethics Statement도 생성 원고의 사실과 독창성, 주장 타당성에 대한 책임이 사람에게 있다고 적었어요.
마무리
논문 자동 작성 AI는 초안을 빠르게 만들어 주지만 검증과 책임은 여전히 사람 몫이에요. PaperOrchestra의 핵심은 수치와 출처를 통제하는 구조에 있었어요. 우리 팀 보고서 에이전트에 수치 근거표, 출처 확인 단계, 새 사실 금지 규칙이 있는지 먼저 확인해 보세요. 이미 있다면 그것만으로도 충분한 출발점이에요. 판단은 팀의 몫이니 천천히 따져 보셔도 돼요.
자주 묻는 질문
논문 한 편 만드는 데 얼마나 걸리나요?
논문 부록에 따르면 평균 39.6분이에요. 다만 무작위 10편(CVPR 5편, ICLR 5편)을 단일 워커로 돌리고 방법마다 최장·최단 시간을 뺀 평균이라 200편 전체 평균이 아니에요. 같은 조건에서 AI Scientist-v2는 35.1분, Single Agent는 3.3분이었어요.
모의 채택률 84%는 실제 학회 통과라는 뜻인가요?
아니요. LLM 자동 심사기(ScholarPeer)가 내린 모의 판정이에요. 논문에 따르면 모의 채택률은 PaperOrchestra가 CVPR 84%, ICLR 81%이고 사람 원본은 CVPR 86%, ICLR 94%예요. 실제 학회 채택이 아니에요.
그림도 AI가 알아서 그려 주나요?
그래프·도식 에이전트가 있지만 CLI 기본값은 꺼짐이고, 사람 평가는 그림을 원본 논문 그림으로 통일한 조건이었어요. 논문 부록 A는 그림 환각 통제가 제한된다고 밝혔어요.