Memorilla는 RAG와 뭐가 다를까요? 기억 토큰 16개의 조건 정리 (2026 기준)
 퀀텀점프클럽 정상록11분 읽기8 views
무료 자료
PDF · 무료
AI에게 필요한 정보만 모아 주는 새 방식 쉽게 읽기
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
Memorilla는 RAG와 뭐가 다를까요? 기억 토큰 16개의 조건 정리 (2026 기준)
Memorilla는 문서 묶음 전체에서 질문에 필요한 정보를 모아 기억 토큰 16개로 만들어 동결된 LLM에 넣습니다. 8개 벤치마크 중 5곳에서 모든 기준선을 앞섰어요.
Memorilla는 무엇을 하는 시스템인가요?
Memorilla는 문서나 대화 기록 묶음 전체에서 질문에 필요한 정보를 모아 정해진 개수의 기억 토큰으로 동결된 LLM에 넣는 방식입니다. "그럼 AI가 우리 대화를 전부 기억해 두는 건가요?" 이런 질문이 먼저 떠오르는 게 자연스러워요. 답은 아니오에 가깝습니다. 저장되는 것은 문서 조각별 임베딩이고, 기억 토큰은 질문이 올 때마다 새로 만들어져요.
논문 2.1~2.5절(arXiv v3, 2026-11-03 제출)에 따르면 구조는 세 부품입니다. 동결된 인코더(Qwen3-Embedding-4B)가 문서 조각을 임베딩 하나씩으로 바꿔 저장하고, 학습되는 기억 모듈이 질문을 조건으로 저장된 임베딩 전부를 읽어 기억 토큰을 만들어요. 동결된 LLM은 이 토큰을 질문 텍스트 앞에 붙여 읽습니다. 논문은 "No LLM layer or attention mechanism is changed."라고 밝혔어요. LLM 내부는 건드리지 않는다는 뜻입니다.
기억 토큰은 어떻게 만들어지나요?
논문 2.2절은 기억 모듈이 질문과 무관하게 학습된 슬롯 16개로 시작한다고 설명합니다. 슬롯은 먼저 질문 임베딩을 읽어 조건을 받고, 그다음 저장된 모든 문서 임베딩을 교차 어텐션으로 읽어요. 논문 표현으로는 상위 몇 개를 고르는 방식이 아니라 연속적으로 읽는 방식입니다. 마지막 선형 투영이 인코더 차원(2560)을 LLM 입력 차원(8B 기준 4096)으로 맞춥니다. 학습되는 파라미터는 Qwen3-8B 기준 194,123,776개예요.
문서를 추가할 때 LLM을 다시 학습하지는 않아요. 논문 7절은 새 문서를 LLM 갱신 없이 추가할 수 있다고 쓰고, 프로젝트 페이지는 문서 하나를 추가하는 비용을 인코더 한 번 통과로 설명합니다. 다만 기억 모듈은 LLM마다 따로 학습해야 해요. 새 과제에는 README가 별도 학습 레시피를 안내합니다. 문서 추가와 새 과제 적용은 다른 일이에요.
개수도 구분해야 합니다. 질의응답 8개 벤치마크는 기억 토큰 16개이고, TextWorld 에이전트 실험은 8개예요. "항상 16개"는 아닙니다.
RAG나 문서 전체를 넣는 방식과 무엇이 다른가요?
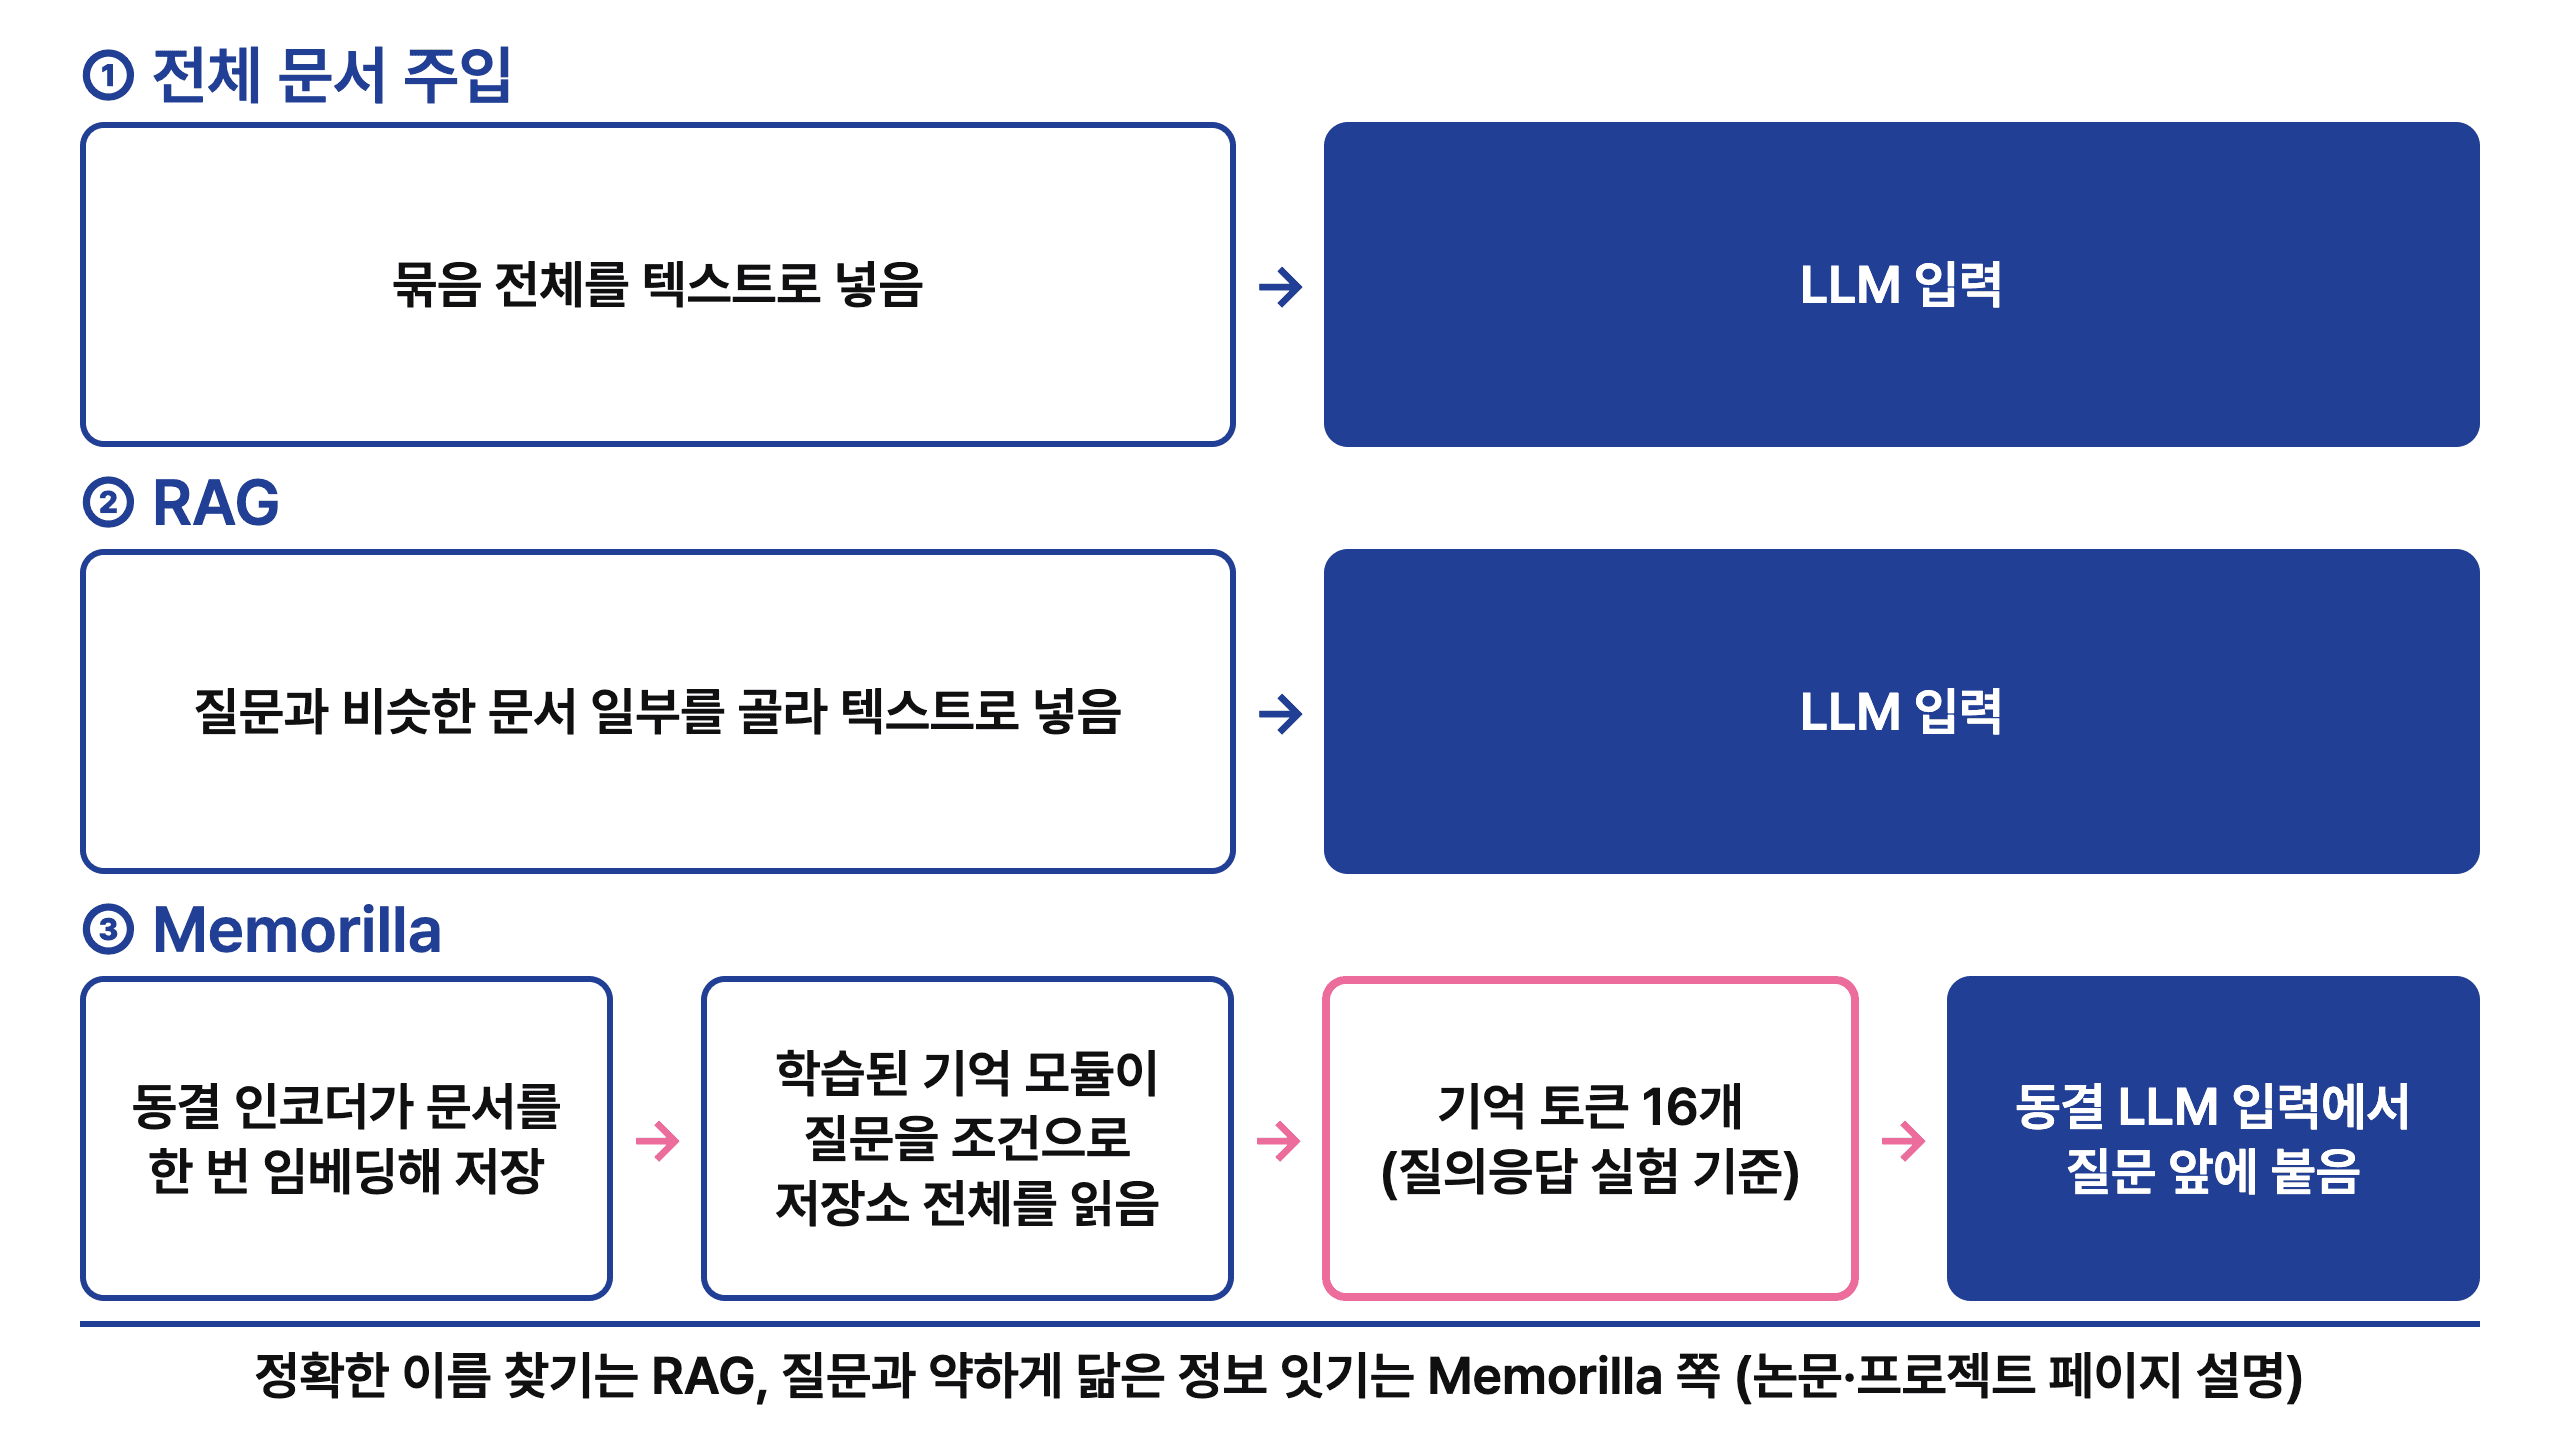
RAG는 문서 일부를 골라 텍스트로 넣고, 전체 문서 주입은 묶음 전체를 텍스트로 넣어요. 논문 서론에 따르면 Memorilla는 문서를 텍스트로 컨텍스트에 넣지 않고 묶음 전체를 질문 조건으로 읽어 기억 토큰으로 넣습니다. 그래서 답이 그대로 적힌 이름 찾기에는 RAG가 맞고, 질문과 약하게만 닮은 정보는 이쪽 구조가 연결할 수 있어요. 대신 정확한 이름 같은 세부를 잃을 수 있다고 프로젝트 페이지는 밝힙니다.
RAG나 문서 전체를 넣는 방식과 무엇이 다른가요?
Memorilla는 문서를 텍스트로 넣지 않고, 질문마다 저장소 전체를 읽어 만든 기억 토큰을 질문 앞에 붙입니다
자료: arXiv 논문(2610.21375)·Memorilla 프로젝트 페이지 · QJC 재구성
논문 5절에 따르면 FactKG에서 Memorilla만 맞힌 질문은 15.9%, RAG-50만 맞힌 질문은 10.0%였고, PersonaMem-v2 단답에서는 27.1% 대 9.2%였습니다. 서로 다른 질문을 푼다는 근거예요. 같은 절은 FactKG에서 결합된 사실이 1개에서 4개로 늘 때 RAG-50의 정확도는 78.73에서 51.75로 떨어지고 Memorilla는 80~89 범위에 머문다고 적었습니다. 두 방법 중 하나라도 맞힌 비율은 실제로 합쳐 본 시스템이 아니라 이론상 상한이에요.
한 줄 요약: Memorilla는 문서 전체를 질문 조건으로 읽어 기억 토큰으로 넣는 방식이고, 정확한 이름 찾기는 RAG가 맞는 서로 다른 도구입니다.
공개된 수치는 어떤 조건에서 나왔나요?
논문 표 11은 동결 Qwen3-8B에 기억 토큰 16개를 쓴 조건으로 8개 벤치마크를 비교합니다. 이 표에 따르면 PersonaMem-v2·FactKG·TriviaQA·LaMP-4·LaMP-7 다섯 곳은 모든 기준선보다 높고, PersonalizationV4·NarrativeQA·PubMedQA 세 곳은 낮아요. PersonalizationV4와 NarrativeQA는 MemoRAG에 이은 2위입니다. 8개 평균은 Memorilla 49.68, xRAG 41.92로, 서로 다른 지표를 합친 평균이라는 단서가 프로젝트 페이지에 붙어 있어요.
| 벤치마크(지표) | 전체 문서 주입 | 최강 기준선 | Memorilla | 판정 |
|---|---|---|---|---|
| PersonaMem-v2 (단답 정확도) | 27.92 | 30.90 (xRAG) | 44.60 | 1위, 벤치마크별 추가 미세조정 |
| PersonalizationV4 (단답 정확도) | 59.12 | 67.88 (MemoRAG) | 66.65 | 2위, 벤치마크별 추가 미세조정 |
| PubMedQA (정확도) | 67.00 | 69.00 (LLMLingua-2) | 59.00 | 열세 |
| FactKG (정확도) | 80.43 | 80.43 (전체 문서 주입) | 84.33 | 1위 |
| NarrativeQA (ROUGE-L) | 17.99 | 20.51 (MemoRAG) | 19.31 | 2위 |
| TriviaQA (EM) | 52.60 | 56.60 (MemoRAG) | 57.00 | 1위 |
| LaMP-4 (ROUGE-L) | 14.21 | 16.10 (xRAG) | 18.15 | 1위 |
| LaMP-7 (ROUGE-L) | 43.71 | 46.84 (xRAG) | 48.37 | 1위 |
FactKG부터 보겠습니다. 논문 표 11에 따르면 Memorilla는 정확도 84.33%로, 같은 디코더에 문서 전체를 넣은 경우의 80.43%보다 3.90%p 높았습니다. 이 수치는 벤치마크별 추가 미세조정이 없는 멀티태스크 체크포인트 그대로입니다. 문서 유래 토큰은 전체 문서 주입보다 108배 적었어요.
PersonaMem-v2의 44.60%는 벤치마크별 추가 미세조정을 거친 결과예요. 논문 표 11에 따르면 최강 기준선 xRAG의 30.90%보다 13.70%p 높고 전체 문서 주입의 27.92%보다 16.68%p 높습니다. 문서 유래 토큰은 전체 문서 주입보다 1,974배 적고요. 아무 문서도 주지 않은 경우는 25.64%였습니다.
4,212배라는 숫자는 NarrativeQA 한 곳의 값입니다. 동결 Qwen3-8B 기준 질의당 문서 토큰이 전체 문서 주입은 67,385개, Memorilla는 16개라서 나온 배수예요. 질문과 공통 지시는 센 값에서 뺐습니다. 같은 벤치마크의 ROUGE-L에서 Memorilla는 19.31로 전체 문서 주입의 17.99보다 높지만 MemoRAG의 20.51보다 낮아요.
지연 27배도 조건이 붙습니다. 논문 부록 F 표 14는 H100-80GB 한 장, 배치 1, 문서 512개(약 128K 토큰) 조건에서 Memorilla의 종단 지연을 739ms, YaRN을 켠 전체 문서 주입을 19,932ms로 적었어요. 이 비율이 27배입니다. RAG 지연은 측정하지 않았습니다. 문서가 1개일 때는 740ms 대 749ms로 거의 같았어요.
TextWorld 실험은 설정이 다릅니다. 동결 Qwen3-4B-Instruct-2507 에이전트에 기억 토큰 8개를 강화학습으로 붙였더니 보류 게임의 3회 시도 평균 성공률이 전체 기록만 넣은 경우 18.6%에서 24.2%로 올랐어요. 기억이 전체 기록을 대체하지 않고 덧붙는 설정입니다.
공정하게 보려면 하나 더 봐야 해요. 논문 2.6절에 따르면 Stage 3은 평가 벤치마크 8개의 학습 분할을 합친 멀티태스크 미세조정입니다. 전체 문서 주입이나 RAG처럼 텍스트를 그대로 넣는 비교 방식은 같은 동결 LLM에 글을 넣을 뿐 따로 학습하지 않아요.
어디서 약한가요?
가장 뚜렷한 곳은 PubMedQA입니다. 논문 표 11에서 Memorilla는 59.00%로, LLMLingua-2의 69.00%와 전체 문서 주입의 67.00%보다 낮아요. 논문 4절은 초록 네 개가 합쳐 324 토큰뿐이라고 설명하고 프로젝트 페이지는 원문이 짧으면 텍스트를 직접 읽는 편이 낫다고 적습니다.
논문 4절에 따르면 MemoRAG는 NarrativeQA ROUGE-L에서 Memorilla보다 문서 토큰을 50배 더 넣어 앞서고 PersonalizationV4에서는 690배 더 넣어 앞섭니다.
논문 한계 절은 "Memorilla can lose fine-grained factual details, likely because the document encoder was never trained for memory compression."이라고 적습니다. 실험이 Qwen 인코더와 Qwen 디코더 조합뿐이라 다른 모델 계열은 미검증입니다.
지금 써 볼 수 있나요?
2026-11-07 기준으로 닫힌 API 모델에는 붙일 수 없습니다. 프로젝트 페이지는 "Because it writes memory directly into the LLM’s input embeddings, it requires open model weights and a memory module trained for each LLM."이라고 밝혀요. 기억 토큰을 입력 임베딩에 직접 넣기 때문에 공개 가중치가 필요하다는 뜻입니다.
공개 체크포인트는 Qwen3-8B와 Qwen3-Embedding-4B 조합 전용이고 라이선스는 Apache-2.0입니다. README는 Linux와 CUDA GPU가 필요하고 시작 예제에는 80GB GPU 한 장이 든다고 적습니다. 세 단계 학습은 H100 80GB 4장에서 약 19시간, 데이터와 임베딩 다운로드는 약 310GiB가 든다고 README는 적었어요.
데이터는 사정이 달라요. 데이터셋 카드는 "Some sources are restricted to non-commercial use."라고 적습니다. 비상업 조건이 붙은 데이터로 카드 표에 QuAIL·SAMSum·DialogSum·MS MARCO가 올라 있어요. 비상업 데이터가 섞인 학습으로 만든 체크포인트를 상업적으로 써도 되는지는 카드와 README에 판단 문장이 없어요.
한국어 평가는 확인한 범위에서 없어요. 평가 벤치마크와 학습 데이터 모두 영어입니다.
비공식 재현도 있습니다. ranjankndev의 저장소는 "It is an independent, scaled-down implementation, not the authors' code."라고 밝히고 작은 모델로 Kaggle T4에서 돌린 노트북입니다. FactKG 보류 주장 1,000개에서 잠재 기억은 65.9%, 전체 문서 주입은 64.7%, RAG top-20은 67.2%였습니다. 저장소는 이를 통계적으로 비슷한 수준으로 적었어요.
우리 팀은 무엇을 가져가면 되나요?
여기서부터는 제 해석입니다. 논문이 직접 한 말은 아니에요. 세 가지 기준만 가져가시면 됩니다.
- 쓰는 모델의 가중치를 직접 돌릴 수 있나요? 닫힌 API만 쓴다면 이 방식은 후보에서 빠집니다.
- 질문이 정확한 이름 찾기인가요, 여러 사실을 엮는 일인가요? 앞쪽은 RAG가 맞는 일입니다.
- 한국어 성능과 상업 이용 가능 여부는 공개 자료에 답이 없으니 우리 데이터로 직접 시험해 봐야 해요.
마무리
Memorilla는 문서 묶음 전체를 질문 조건으로 읽어 기억 토큰으로 넣는 방식입니다. 높은 곳과 낮은 곳, 조건이 모두 공개돼 있어요. 우리 팀 상황에 맞는지부터 따져보셔도 충분합니다. 판단에 필요한 기준은 위에 정리해 뒀어요.
자주 묻는 질문
ChatGPT나 Claude에 Memorilla를 바로 붙일 수 있나요?
아니요, 지금은 어렵습니다. 프로젝트 페이지는 기억을 LLM 입력 임베딩에 직접 쓰기 때문에 공개 가중치와 LLM별로 학습한 기억 모듈이 필요하다고 밝힙니다.
4,212배 적은 토큰이라는 말은 어디서나 성립하나요?
아니요, NarrativeQA 한 곳에서 질문과 지시를 뺀 문서 토큰을 전체 문서 주입과 비교한 값입니다. 논문 표 11 기준으로 같은 비교의 배수는 FactKG가 108배, PubMedQA가 20배였어요.