Claude의 dreaming은 무엇을 바꿨을까요? 에이전트 기억 연구의 수치와 조건 (2026 기준)
 퀀텀점프클럽 정상록9분 읽기7 views
무료 자료
PDF · 무료
AI의 기억을 쉬는 시간에 정리하면 생기는 일
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
Claude의 dreaming은 무엇을 바꿨을까요? 에이전트 기억 연구의 수치와 조건 (2026 기준)
Anthropic 연구에서 dreaming은 틀린 메모를 고쳤지만 위키만으로는 검색을 넘지 못했습니다. 둘을 함께 쓴 조건이 61%로 가장 높았어요.
dreaming은 무엇이고 AI가 꿈을 꾸는 건가요?
dreaming은 쉬는 시간에 지난 작업 기록을 다시 읽고 메모를 고치거나 새로 정리하는 과정이에요. "그럼 AI가 정말 꿈을 꾸는 건가요?" 이름만 보면 그런 의문이 들죠. 답은 아니오예요. Anthropic이 2026-11-06 공개한 연구 글에 따르면 "This process is often called dreaming"이라고 적혀 있고, 기록을 돌아보며 오류를 고치거나 새 메모를 만드는 과정에 붙인 이름이에요. 해마와 수면 중 재생은 설계 비유로 쓴 것이고 모델이 잠을 잔다는 주장은 아닙니다.
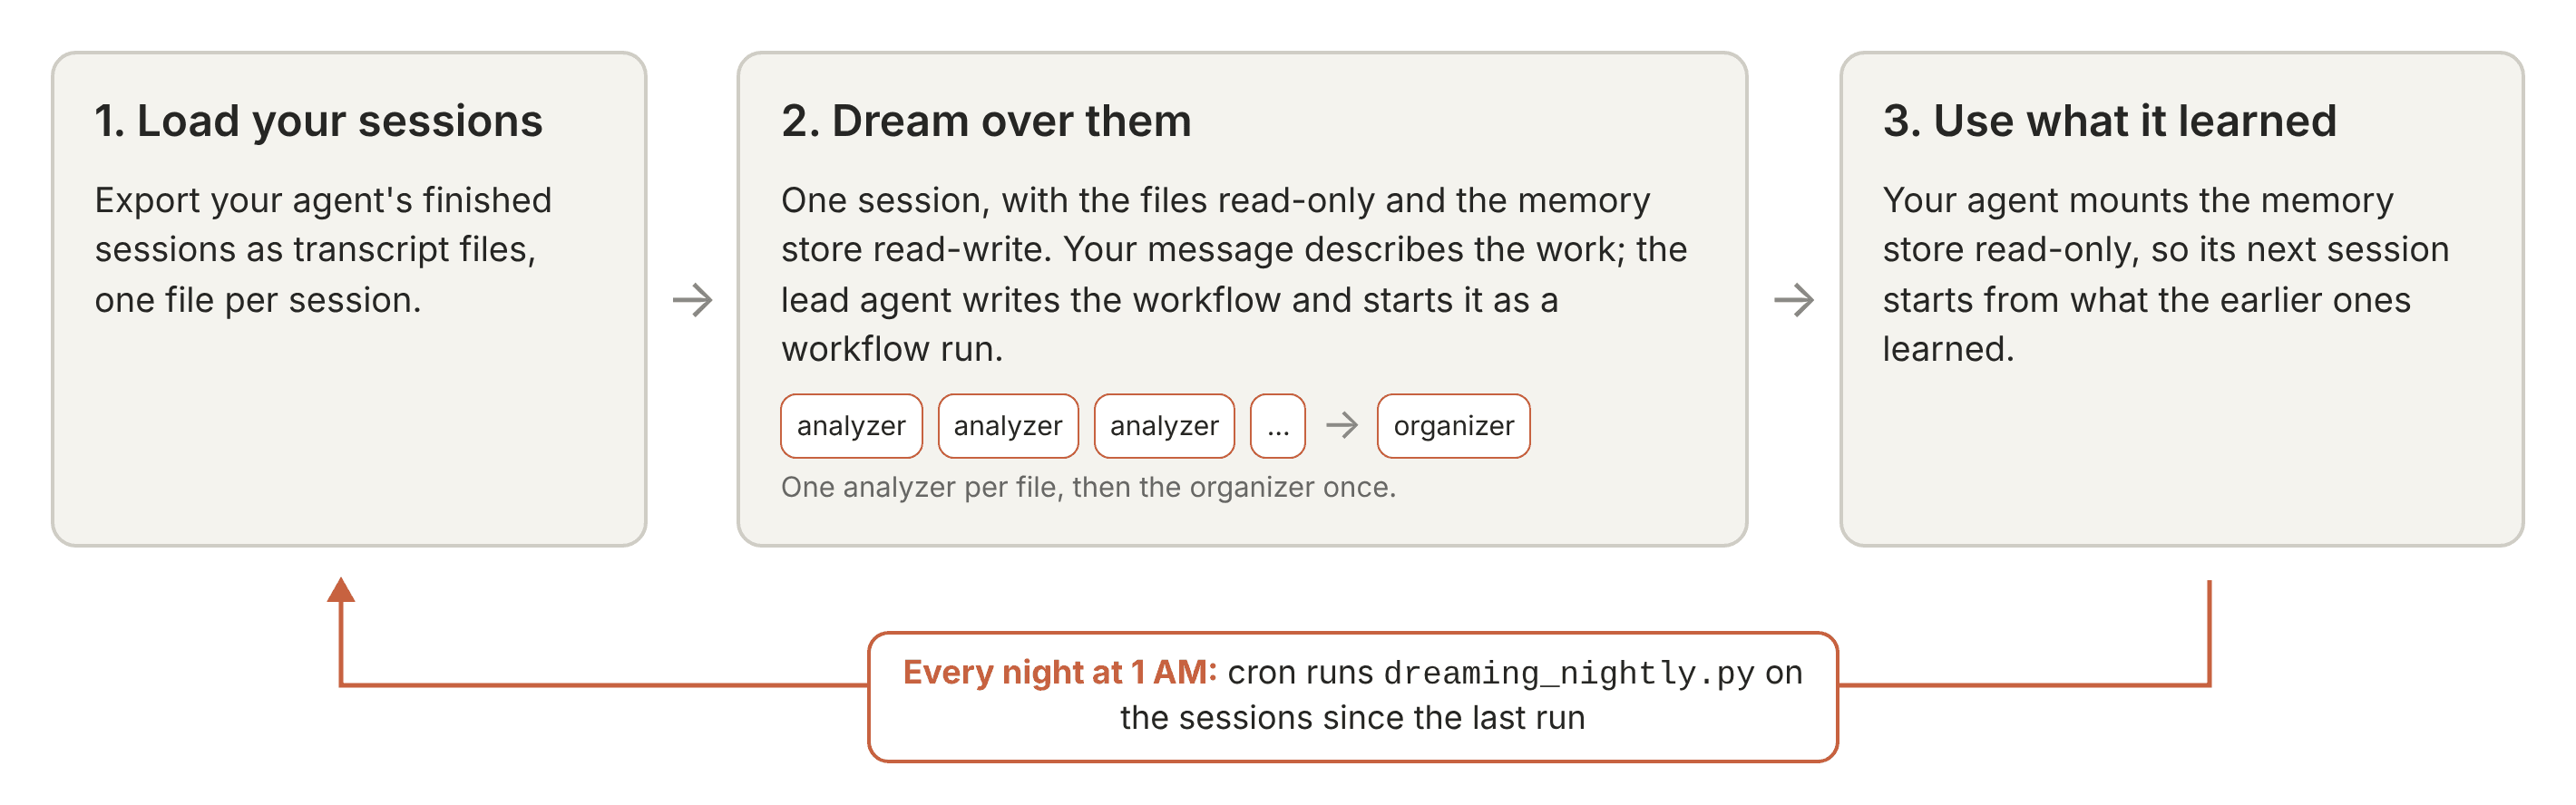
Claude 쿡북의 dreaming 예제 흐름도: 끝난 세션 기록을 파일로 내보내고, 한 세션에서 분석 에이전트들과 정리 에이전트가 기억 저장소를 정리한 뒤, 다음 세션이 그 저장소를 읽기 전용으로 쓴다. 예제는 매일 새벽 1시 cron으로 돈다.
이미지 출처: platform.claude.com
연구 글은 기억을 대화 기록, 메모, 위키 같은 정리본, 매 세션 미리 넣는 주입층의 네 층으로 나눕니다. dreaming은 아래 기록을 읽어 위쪽 층을 고치고 채우는 작업이에요. 아이디어의 뿌리는 Letta와 UC Berkeley 연구진이 2025-04-17 공개한 sleep-time compute 논문이에요. HN 스레드(144점)에서 살펴본 최상위 댓글 21개 중에는 의인화라는 비판이 많았어요.
기억을 많이 쌓을수록 에이전트가 나아지나요?
Anthropic 연구 글은 무엇을 저장할지 고르는 판단을 포켓몬 레드 실험으로 살폈어요. 모델별 1회 실행이고 약 1만 스텝 시점을 비교한 결과예요. Sonnet 3.7은 파일 413개를 쓰고도 배지를 1개 땄고, Fable 5는 파일 9개와 최상위 global.md 하나로 배지 4개를 땄습니다. Opus 5.5는 현재 목표와 다음 단계만 담은 작은 메모 폴더를 고쳐 쓰며 게임을 끝까지 깼어요. 파일이 적은 쪽이 앞섰지만 한 번씩 돌린 결과라 일반화는 어려워요.
dreaming이 힘을 낸 장면은 메모 정정이었어요. 위치를 잘못 적은 메모를 대화 기록과 대조해 고치자, 고친 메모로 돌린 실행은 누적 행동 1,935번째에 다음 도시에 도착했습니다. 고치지 않은 메모로 돌린 실행은 같은 함정에 세 번 떨어진 뒤 끝내 도착하지 못했어요.
Stainless 위키 실험의 수치는 어떤 조건에서 나왔나요?
핵심 숫자는 Stainless 사내 문서 실험에서 나왔어요. 약 35만 파일, 약 4억 2천만 토큰 규모의 문서를 Opus 5 에이전트가 위키로 정리하게 하고 25문항의 채점 기준 충족률을 쟀습니다. Stainless는 Anthropic이 2026-05-18 인수를 발표한 회사예요.
| 조건 | dreaming 2세션 | dreaming 128세션 |
|---|---|---|
| 위키만 사용 | 13% | 48% |
| 위키와 검색 함께 | 54% | 61% |
| 검색만 사용(위키 없음) | 53% | 53% |
표는 Opus 5 에이전트가 25문항에 답한 채점 기준 충족률이에요. 위키만 쓴 조건은 35%p 올랐지만 최고점 48%는 검색만 쓴 53%보다 5%p 낮습니다. 위키와 검색을 함께 쓴 61%는 검색만 쓴 조건보다 8%p 높아요. 예시 위키는 dreaming 2세션 뒤 103페이지, 128세션 뒤 222페이지였어요.
Anthropic 연구 글은 "we found that the wiki helped Claude the most when we also gave it access to a search tool"라고 적었고, 검색 도구까지 줬을 때 위키가 가장 도움이 됐다는 뜻이에요. 원문은 둘을 함께 쓰면 문항당 약 2만 토큰을 아꼈다고 쓰지만 비교 대상은 밝히지 않았고, 위키를 만드는 비용은 따로 들어요. 이 말뭉치는 공개되지 않아 재현할 수 없습니다.
위키는 어떤 과제에서 도움이 됐고 어디서 헛돌았나요?
합병 문서 24문항 중 여러 문서를 엮어야 하는 문항에서는 위키를 본 경우 87%, 검색만 쓴 경우 73%였어요. 14%p 차이예요. 반대로 답이 대부분 문서 하나에 있는 과제에서는 위키의 뚜렷한 이득이 없었습니다. 문서 10개 115KB로 만든 위키가 203KB, 원문의 1.77배로 불어난 사례도 있어요. 연구 글은 이를 "Claude had made an extremely detailed wiki that effectively abstracted nothing."라고 평했습니다. 너무 세세해서 아무것도 추상화하지 못한 위키라는 뜻이에요.
여러 에이전트가 공유 페이지 하나에 동시에 쓸 때는 계약 사실 57개 중 41개(72%)만 브리프에 들어갔어요. 계약마다 에이전트 하나가 자기 페이지를 쓰고 조항을 원문 그대로 인용하게 지시를 고치자 57개가 모두 남았습니다.
기억 저장 규칙을 정해 주면 성능이 좋아지나요?
CL-Bench 데이터베이스 과제에서 실패만 기록하라는 규칙을 미리 줬더니 기억이 주는 이득이 Opus 5에서 0.234, Opus 4.7에서 0.150 줄었어요. Anthropic 연구 글은 "We’ve found that it helps to tell Claude what memory is for, but not how to use it."라고 적습니다. 기억이 무엇을 위한 것인지는 알려 주되 쓰는 법은 정하지 말라는 뜻이에요.
예외는 구형 Sonnet 4.6이에요. 답하기 전에 기억을 먼저 읽고 가설을 검증하라는 지시를 더하자 점수가 0.641이 됐습니다. 거의 두 배라는 표현은 기억 없는 기준선 0.330과 비교할 때 맞고, 지시 없이 기억만 쓴 0.364와는 약 1.76배예요. Sonnet 5는 지시 없이도 10번 중 9번 답하기 전에 기억을 읽었지만 Sonnet 4.6은 절반이 안 됐어요. 강한 모델에는 규칙을 덜 주고 약한 모델에는 지시를 보태라는 정리는 제 해석이에요.
지금 Claude Code와 API에서 무엇을 쓸 수 있나요?
Claude Code 메모리 문서에 따르면 자동 메모리는 MEMORY.md의 첫 200줄 또는 25KB 중 먼저 닿는 쪽까지만 매 세션 읽어요. CLAUDE.md는 파일당 200줄 미만을 권하며 이유를 "Longer files consume more context and reduce adherence."라고 적습니다. 긴 파일은 맥락을 더 쓰고 지침을 덜 따른다는 뜻이에요. Claude Code가 dreaming을 자동으로 돈다는 근거는 공식 문서에 없고, 연구 글도 주입층을 작게 유지하는 방식이 같다고만 말합니다.
직접 돌릴 수 있는 기능은 Claude API Managed Agents의 Dreams예요. 신청이 필요한 연구 미리보기입니다. 공식 문서에 따르면 입력은 기억 저장소 하나와 지난 세션 1~100개이고 원본은 그대로 둔 채 새 저장소를 만들어요. 비용은 고른 모델의 표준 토큰 요금이에요. 쿡북 예제는 기록 11개(283KB)에 정가 $0.36, 약 2분 30초가 들었고 긴 기록 50개(약 12MB)에는 정가 약 $8, 약 10분이 걸렸어요. knowledge-wiki 퀵스타트는 기록된 core 등급 실행이 23분, 정가 약 $16였어요. 연구 글도 "Dreaming is one way to fix these mistakes (Figure 8), but it requires compute."라고 인정합니다. 기억 저장소는 베타이고 기본 권한이 읽기·쓰기예요. 문서는 에이전트가 외부 입력을 다루면 프롬프트 주입으로 악성 내용이 기억에 쓰일 수 있다고 경고하고, 고칠 필요가 없는 저장소는 읽기 전용으로 붙이라고 권해요.
내 에이전트에는 무엇을 가져가면 되나요?
여기서부터는 원문이 직접 한 말이 아니라 제 해석이에요. 실험에서 본 근거와 함께 일곱 가지를 꼽았어요.
- 매 세션 미리 넣는 기억은 색인처럼 작게 두고 세부는 아래 층에 두며 링크만 남겨요.
- 기억의 목적은 알려 주되 쓰는 규칙은 고정하지 않아요. 강한 모델 기준이에요.
- 원본 대화 기록은 지우지 않고 정답지로 남겨요. 메모 정정은 기록과 대조해서 가능했습니다.
- 위키는 검색을 대체하지 않고 보태요. 여러 문서를 엮는 질문에서 이득이 컸어요.
- 꼭 지켜야 할 사실은 원문 그대로 인용해 담당별 페이지에 둬요.
- 외부 입력을 다루는 에이전트라면 고칠 필요가 없는 기억은 읽기 전용으로 붙여요.
- 정리 주기와 범위는 비용으로 정하고 작은 묶음에서 시작해요.
마무리
Anthropic 연구는 dreaming이 틀린 메모를 고치는 데 쓸모가 있다는 것과, 위키가 검색을 대신하지는 못했다는 것을 함께 보여 줍니다. 수치마다 Opus 5 에이전트, 사내 문서 25문항 같은 조건이 붙어 있어요. 포켓몬 비교는 모델별 1회 실행이에요. 우리 에이전트에 맞는지는 작은 묶음 하나로 먼저 시험해 보셔도 충분합니다.
자주 묻는 질문
Claude Code도 dreaming을 하고 있나요?
아니요, 그렇게 볼 근거는 없습니다. Claude Code 메모리 문서에는 dreaming 기능이 나오지 않고 자동 메모리는 MEMORY.md 첫 200줄 또는 25KB까지만 읽어요.
Dreams는 지금 누구나 쓸 수 있나요?
아니요, 신청이 필요한 연구 미리보기입니다. 공식 문서에 따르면 고른 모델의 표준 토큰 요금으로 과금되고 기억 저장소는 베타예요.
위키가 검색보다 낫다는 뜻인가요?
아니요. 위키만 쓴 최고점은 48%, 검색만 쓴 조건은 53%였어요. 둘을 함께 쓴 61%가 가장 높았어요.