내 클로드코드 스킬, 왜 안 뜨는지 아세요? claude plugin eval로 채점해본 후기 (2026)
 퀀텀점프클럽 정상록11분 읽기12 views
무료 자료
PDF · 무료
내 AI 스킬, 진짜 작동하는지 채점기로 확인하기 — 비개발자를 위한 쉬운 가이드
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
내 클로드코드 스킬, 왜 안 뜨는지 아세요? claude plugin eval로 채점해본 후기 (2026)
목차
- 왜 내 스킬은 항상 안 뜨는 걸까요?
- claude plugin eval, 정확히 뭘 하나요?
- 점수보다 Δ가 진짜 지표입니다
- 채점자 6종, 4개는 무료고 2개는 돈이 듭니다
- 클로드코드 CI 게이트는 이렇게 겁니다
- 우리 하네스를 실제로 채점하니 평균 Δ가 음수였습니다
- 지금 반응은 어느 정도인가요?
- 자주 묻는 질문
왜 내 스킬은 항상 안 뜨는 걸까요?
결론부터 말씀드리면, 스킬이 안 뜨는 원인은 성능보다 description 한 줄인 경우가 많습니다. "분명 잘 만들었는데 왜 자꾸 안 뜨죠?" 스킬이나 플러그인을 몇 개 만들어본 분이라면 한 번쯤 품었을 질문이죠. 저도 마찬가지였습니다. Claude Code는 description이 사용자 요청과 얼마나 잘 맞는지로 발동 여부를 가르는데, 이걸 눈으로 확인할 방법이 마땅치 않았거든요. Anthropic이 이 문제를 겨냥해 내놓은 도구가 claude plugin eval입니다. 오늘은 이게 뭘 채점하는지, 저희 클로드코드 플러그인에 실제로 붙여보니 뭐가 나왔는지 정리해보겠습니다.
claude plugin eval, 정확히 뭘 하나요?
공식 문서(code.claude.com/docs/ko/plugin-evals, 2026-09-11 공개)에 따르면 claude plugin eval은 플러그인을 테스트 케이스 모음에 대해 실행하고 결과를 채점하는 CLI입니다. 케이스 하나는 현실적인 프롬프트 1개와 채점자 1개 이상으로 이뤄집니다. 실행 방식은 이렇습니다. 케이스마다 플러그인만 로드된 격리된 비대화형 세션을 새로 띄우고, 프롬프트를 보낸 뒤 완료되거나 턴·시간 제한에 도달할 때까지 돌립니다. 채점자는 최종 응답과 전체 기록, 생성된 파일까지 확인해 통과·실패를 매기고요. 에이전트는 같은 프롬프트에도 매번 조금씩 다르게 답할 수 있어서 1회 실행만으로는 신호가 약합니다. 그래서 기본값이 3회 반복이고, 케이스 점수는 그 실행들의 평균입니다. 통과 기준은 --threshold 옵션으로 정하며 기본값은 1.0이더라고요.
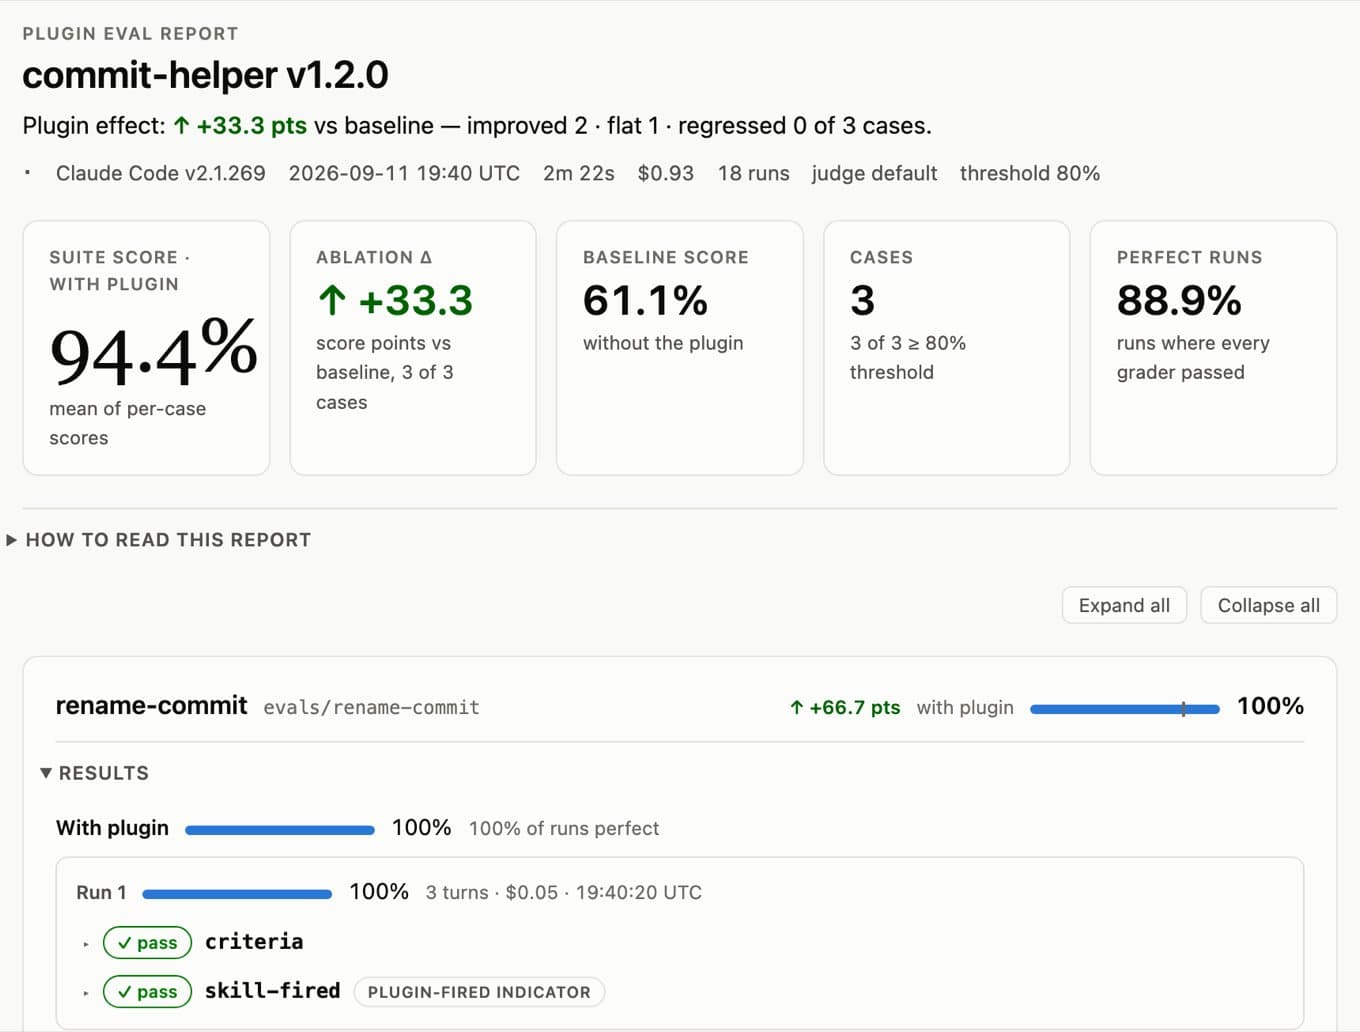
평가 보고서의 상단: "Plugin effect: +33.3 pts vs baseline, improved 2, flat 1, regressed 0 of 3 cases"라고 읽는 판정 줄, 스위트 점수, 제거 델타, 기준선 점수, 임계값을 통과한 케이스 및 완벽한 실행에 대한 5개의 요약 타일, 그 다음 델타, 점수 막대 및 두 그레이더 모두 통과를 표시하는 하나의 실행이 있는 첫 번째 케이스
이미지 출처: code.claude.com
점수보다 Δ가 진짜 지표입니다
Δ(델타): 플러그인을 켜고 잰 점수에서 끄고 잰 점수를 뺀 값. 이 플러그인이 실제로 기여한 몫을 뜻하며, 0이면 플러그인 없이도 같은 결과가 나왔다는 의미입니다.
이 도구를 만든 쪽의 문제의식은 명확합니다. 공식 문서는 이렇게 밝히고 있습니다.
"높은 점수 자체만으로는 플러그인이 도움이 되었는지 알려주지 않습니다. Claude가 플러그인 없이도 동일하게 잘 수행할 수 있기 때문입니다."
그래서 각 케이스는 기본적으로 플러그인 없이 한 번 더 돌아갑니다(ablation). 결과표는 세 열로 나옵니다.
| 열 | 의미 |
|---|---|
| WITH | 플러그인을 로드한 상태의 점수 |
| W/OUT | 플러그인 없이 돌린 기준선 점수 |
| Δ | 둘의 차, 즉 플러그인이 실제로 기여한 값 |
WITH가 1.00이고 W/OUT도 1.00이면 Δ는 0입니다. 점수만 보면 완벽해 보이지만, 그 플러그인은 이 케이스에서 한 일이 없다는 뜻이죠. 케이스 1개가 6회 실행(3회 반복 × WITH/W/OUT 두 팔)되는 이유가 여기 있습니다. 2026-09-19에 --help로 CLI를 직접 확인해보니 문서보다 한 발 더 나간 설명도 있었습니다. tool_used: Skill처럼 with-only로 표시된 채점자는 점수 계산에서는 빠지고, "플러그인이 발동은 했는가"를 보여주는 지시자로만 쓰인다고 합니다.
채점자 6종, 4개는 무료고 2개는 돈이 듭니다
공식 문서에 정리된 채점자는 총 6종입니다.
| 유형 | 통과 조건 | 판사 모델 호출 |
|---|---|---|
| regex | 정규식이 대상 텍스트에서 발견됨 | 없음 |
| tool_used | 해당 도구 호출 수가 지정 범위 안에 있음 | 없음 |
| tool_order | 두 도구가 모두 호출되고 순서가 맞음 | 없음 |
| file_exists | 실행 중 생성된 파일이 glob과 일치함 | 없음 |
| llm | 판사 모델 3표 중 2표 이상 PASS | 있음 |
| baseline | 참조 기록만큼 기준을 충족함 | 있음 |
문서가 권하는 습관도 실용적이에요. 긴 출력물(생성된 파일)은 llm 채점자 대신 파일 내용에 대한 regex로 채점하라는 조언, 케이스마다 결과 채점자 1개와 경로 채점자(tool_used나 tool_order) 1개를 같이 두라는 조언이 눈에 띕니다. tool_used: Skill은 통과했는데 Δ가 음수로 나온다면, 플러그인을 의심하기 전에 판사 모델부터 --judge-model sonnet으로 바꿔서 다시 돌려보라고 문서는 권합니다. 사용자 정의 코드 채점자는 아직 없습니다.
클로드코드 CI 게이트는 이렇게 겁니다
명령 한 줄이면 CI에 편입할 수 있습니다.
claude plugin eval . \
  --trust-plugin \
  --json results.json \
  --threshold 0.8 \
  --model claude-sonnet-5 \
  --judge-model claude-haiku-4-5 \
  --no-publish \
  --max-cost-usd 20
종료 코드는 다섯 가지입니다.
| 코드 | 의미 |
|---|---|
| 0 | 전 케이스가 threshold 이상, 케이스 파일도 전부 로드됨 |
| 1 | threshold 미달, 케이스 로드 실패, 실행 시작 실패 등 |
| 2 | 부분 실행. --max-cost-usd 상한 도달 또는 자격 증명 거부 |
| 130 | 중단됨(부분 결과는 기록됨) |
| 143 | 종료됨(CI 타임아웃 등) |
--model과 --judge-model을 CI에서 고정해야 하는 이유도 문서가 짚습니다. 두 값을 고정하지 않으면 모델이 최신 버전으로 자동 롤아웃될 때 그 변화가 플러그인 회귀로 오인될 수 있거든요. 비용 확인도 빼놓을 수 없습니다. eval 실행과 판사 채점 전부 계정의 실제 모델 호출이라 플랜 사용량이나 API 청구에 그대로 잡히고, --max-cost-usd는 정가 추정 상한일 뿐 이미 시작된 실행까지 막아주지는 않습니다. 요구 버전은 Claude Code 2.1.269 이상이고, 저희 로컬 버전은 2.1.278이라 조건은 충족한 상태였습니다.
우리 하네스를 실제로 채점하니 평균 Δ가 음수였습니다
이론만 늘어놓으면 재미없으니 저희 하네스에 직접 돌렸습니다. 대상은 superpowers 6.3.0, 저희 개발 프로세스 방법론의 기준이 되는 플러그인입니다. 2026-09-19 실행 결과입니다.
| 항목 | 값 |
|---|---|
| 케이스 | 5개 |
| 통과 | 3 / 5 (overallScore 0.60) |
| 평균 Δ | −0.20 |
| 비용·시간 | $2.25 · 445초 |
| 설정 | ablation with-without · 에이전트 claude-opus-5[1m] · 판사 haiku |
케이스별로 보면 음수가 어디서 나왔는지 분명합니다.
| 케이스 | WITH | Δ |
|---|---|---|
| brainstorm-before-building | 0.00 | −1.00 |
| debug-root-cause-first | 1.00 | 0.00 |
| no-ceremony-on-plain-question | 1.00 | 0.00 |
| tdd-failing-test-first | 0.00 | 0.00 |
| verify-before-claiming-done | 1.00 | 0.00 |
평균 −0.20은 전부 brainstorm-before-building 한 케이스에서 나왔습니다. 그 케이스에서는 플러그인을 켠 쪽이 껐을 때보다 나빴습니다. 나머지 네 개는 Δ가 0이니, 있든 없든 결과가 같았다는 뜻이고요.
이 숫자를 그대로 믿으면 안 되는 이유
공식 문서가 바로 이 상황의 진단 순서를 적어뒀습니다.
"케이스의
tool_used: Skill채점자가 통과하지만Δ가 음수인 경우 플러그인 전에 판사를 의심합니다. 작은 판사 모델은 루브릭이 설명하는 것과 다르게 형식이 지정되었기 때문에 올바른 답변을 잘못 표시할 수 있습니다."
저희 실행의 판사는 기본값인 haiku였습니다. 그래서 "우리 방법론이 해롭다"는 해석은 아직 지지할 수 없습니다. --judge-model sonnet으로 다시 돌려보는 게 다음 순서입니다. 점수가 나왔다고 결론이 나온 건 아니라는 얘기죠.
손으로 부르면 인증에서 막힙니다
같은 날 이 글을 쓰면서 claude plugin eval을 직접 호출했더니 이렇게 끝났습니다.
error: exit 1: Not logged in · Please run /login
1 case(s) · 1s · $0.00 · partial (stopped: authentication failed)
원인은 eval의 격리 방식이었습니다. eval은 케이스를 HOME까지 봉인된 클린룸에서 돌리기 때문에 호출한 셸의 자격 증명이 그대로 이어지지 않습니다. 저희 스위트에는 이미 이 문제를 푸는 실행 스크립트가 있었고, README 첫 문단에 "claude plugin eval을 손으로 부르지 말고 run.sh를 쓴다"고 적혀 있었습니다. 같은 머신에서 그 경로는 partial: false로 완주했고요. 인증이 막힌 게 아니라 제가 그 문장에 도달하지 못했던 겁니다.
채점 전에 눈으로 잡힌 결함
my-toolkit 플러그인의 example 스킬은 description이 생성 템플릿 그대로였습니다.
"TODO — describe WHEN Claude should use this. Include trigger phrases users might say..."
description은 Claude가 사용자 요청과 맞춰보는 문자열입니다. 이게 TODO 상태면 어떤 프롬프트를 던져도 안정적으로 발동할 수 없습니다. eval을 돌리기도 전에, 읽기만 해도 나오는 결함이라는 점이 인상적이었습니다.
더 큰 공백은 따로 있었습니다
검증된 채점 인프라를 갖고 있는데 측정 대상은 외부 플러그인 하나뿐입니다. 저희가 직접 만든 스킬 106개(글로벌 86 + 로컬 20)에는 claude plugin eval 케이스가 0건입니다(skill-creator 포맷의 evals/evals.json을 가진 스킬은 따로 있습니다). 도구를 들이는 것과 쓰는 것은 다른 일이더라고요.
지금 반응은 어느 정도인가요?
나온 지 얼마 안 된 도구라 반응 자체가 아직 많지 않습니다. HN에 2026-09-11 올라온 "Anthropic released a CLI to evaluate skills and plugins" 글은 3점에 댓글 1개였고, 그 댓글은 비슷한 문제의식으로 오픈소스 도구를 먼저 만들었던 개발자의 반가움 표시였습니다. 2026-09-17에는 다른 각도의 글도 올라왔어요. 상용 채점 서비스(skillcrossroads.com)를 만든 사람이 공개된 클로드코드 스킬 216개를 린팅했더니 69%가 안정적으로 발동하지 않았다고 주장한 글입니다. 다만 이 수치는 독립 연구가 아니라 그 서비스를 파는 쪽의 자체 주장이라는 점은 감안해서 읽어야 합니다. 같은 사이트가 "트리거·발견성"을 스킬이 망가져 보이는 1순위 원인으로 내세우고 있어서, 진단과 판매가 같은 문장에 섞여 있는 셈이거든요.
마무리
점수 하나로 좋고 나쁨을 가리는 도구가 아니라, "이 플러그인이 정말 일을 했는가"를 묻는 도구입니다. 당장 전면 도입할지는 팀 상황에 따라 다를 것 같아요. 인증 경로부터 한 번 점검해보시고, 케이스 두어 개로 가볍게 시작해보셔도 충분합니다.
자주 묻는 질문
claude plugin eval은 무료인가요?
아니요. eval 실행과 판사 모델 채점 모두 계정의 실제 모델 호출이라 플랜 사용량이나 API 청구에 그대로 잡힙니다. --max-cost-usd로 정가 추정 상한은 걸 수 있지만, 이미 진행 중인 실행 때문에 그 상한을 넘길 수도 있다고 공식 문서가 밝히고 있습니다.
지금 바로 CI에 넣어도 되나요?
Claude Code 2.1.269 이상이면 명령어 자체는 바로 쓸 수 있습니다. 다만 eval은 HOME까지 봉인된 클린룸에서 케이스를 돌리기 때문에, 호출 방식에 따라 자격 증명이 이어지지 않아 Not logged in으로 중단될 수 있습니다. 저희도 2026-09-19에 직접 호출했다가 그렇게 멈췄고, 래퍼 스크립트를 쓰는 경로에서는 같은 머신에서 정상 완주했습니다. CI에 넣기 전에 실행 경로부터 한 번 확인해보세요.
점수가 높으면 좋은 플러그인 아닌가요?
꼭 그렇지는 않습니다. 공식 문서가 직접 짚는 함정입니다. 플러그인이 있을 때(WITH)와 없을 때(W/OUT) 점수가 똑같이 1.00이면 Δ는 0이고, 그 플러그인은 해당 케이스에서 한 일이 없다는 뜻입니다. 점수보다 Δ를 먼저 봐야 합니다.