graphify 설치하면 AI가 우리 코드를 알아서 이해할까요? 2026 구조와 한계 정리
 퀀텀점프클럽 정상록18분 읽기3 views
무료 자료
PDF · 무료
AI 코딩 도우미에게 저장소 배선도를 쥐여 주는 graphify: 비개발자를 위한 쉬운 가이드
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
graphify 설치하면 AI가 우리 코드를 알아서 이해할까요? 2026 구조와 한계 정리
graphify는 무엇이고 왜 이렇게 자주 눈에 띄나요?
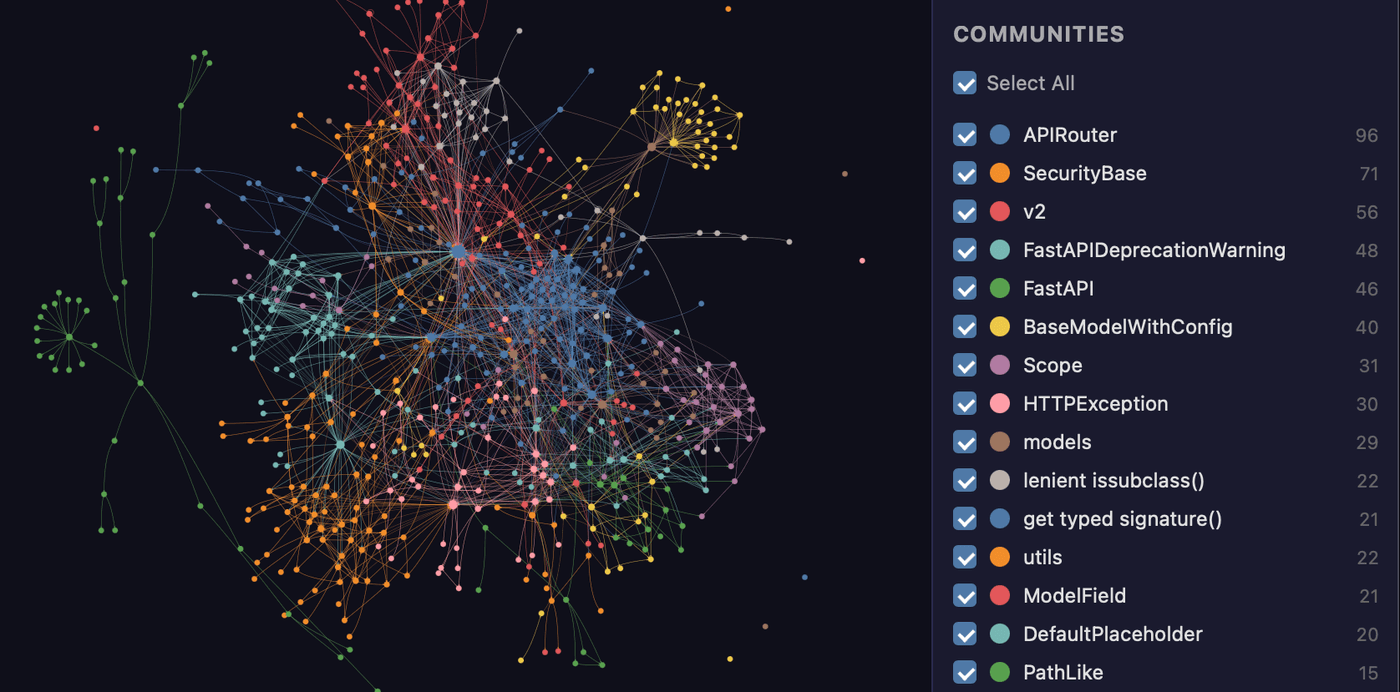
graphify는 AI 코딩 에이전트에게 저장소의 배선도를 쥐여 주는 오픈소스예요. 건물 배선도가 있으면 새로 온 직원이 벽을 다 뜯지 않아도 어느 스위치가 어느 방으로 이어지는지 찾을 수 있죠. 이 도구가 하는 일이 그겁니다. 다만 배선도는 도면일 뿐이라 실제로 전기가 흐르는지는 따로 확인해야 해요.
graphify's interactive graph.html showing the FastAPI codebase as a force-directed knowledge graph with a legend of detected communities
이미지 출처: github.com
"우리 레거시 코드에 붙이면 AI가 구조를 알아서 파악해 주나요?" 도입을 고민하면 이 질문이 먼저 나옵니다. 곧이어 "회사 코드가 밖으로 나가진 않나요?"가 따라오죠. 둘 다 당연한 걱정이에요.
GitHub 저장소 정보에 따르면 2026-10-23 기준 별은 132,865개, 포크는 12,713개이고 라이선스는 Apache-2.0입니다. 저장소 생성일은 2026-04-03, 최신 릴리스는 v0.9.94(2026-10-22)예요. Y Combinator 회사 페이지는 운영사 Graphify Labs를 Summer 2026 배치로 소개합니다. 저장소 설명은 이렇게 시작해요.
graphify란?: 코드 저장소와 문서, SQL 스키마, 설정 파일, PDF를 질의할 수 있는 지식 그래프로 바꿔 주는 도구입니다. Claude Code, Cursor, Codex, Gemini CLI에서 /graphify 스킬로 불러 쓰고, 코드는 로컬 AST 파싱으로 처리해 엣지마다 근거를 남기며, 벡터 저장소는 쓰지 않는다고 소개합니다.
저장소 설명 원문은 "Turn any codebase, with its docs, SQL schemas, configs, and PDFs, into a queryable knowledge graph."로 시작합니다. 어떤 코드베이스든 문서·SQL 스키마·설정·PDF와 함께 질의 가능한 지식 그래프로 바꾼다는 뜻이에요. 뒤이어 "local deterministic AST parsing, every edge explained, no vector store."라고 적었습니다. 로컬에서 결정론적으로 문법 트리를 파싱하고, 모든 연결의 근거를 설명하며, 벡터 저장소가 없다는 말이에요.
이 글은 그 소개문이 얼마나 맞는지 소스와 문서를 대조한 결과입니다. 저희는 2026-10-23 기준 소스를 읽기만 했고 직접 설치해 돌려 보지는 않았어요. 그래서 속도나 한국어 질의 품질 같은 실측값은 없습니다. 순서는 데이터가 어디로 가는지, 질문에 어떻게 답하는지, 토큰 절감 수치의 기준선, 설치와 차단 설정, 한계, 유료판과 비슷한 도구, 한국 실무 활용 순이에요.
코드는 정말 로컬에서 처리되고 문서와 PDF는 어디로 가나요?
코드만 보면 맞습니다. 문서·PDF·이미지는 LLM이 읽어요. ARCHITECTURE.md에 따르면 파이프라인은 detect, extract, build, cluster, analyze, report, export 순으로 이어지고, 이 중 LLM이 주로 개입하는 곳은 문서·PDF·이미지를 읽는 추출 단계이고, 스킬 모드에서는 커뮤니티 이름을 짓는 단계에도 호스트 모델이 쓰입니다.
코드 파일은 tree-sitter(코드 문법 분석기)로 로컬에서 파싱해요. README에 따르면 코드만 있는 저장소는 API 키 없이 그래프를 만들 수 있습니다. 기본 설치에 들어 있는 tree-sitter 문법은 25종이고, SQL 같은 일부는 별도 extra(graphifyy[sql])를 설치해야 해요. 문서 쪽은 사정이 달라서 아래 표처럼 갈립니다.
| 입력 | 처리 | 외부 전송 |
|---|---|---|
| 코드(.py·.ts·.java 등) | tree-sitter 로컬 파싱 | 없음 |
| 영상·음성 | faster-whisper 로컬 전사 | 전사 단계는 없음 |
| 문서·PDF·이미지 (Claude Code 스킬 모드) | 지금 쓰는 어시스턴트 모델이 읽음 | 그 모델 제공사로 전송 |
| 같은 경우에 GEMINI_API_KEY나 GOOGLE_API_KEY가 셸에 있을 때 | Gemini(기본 gemini-3-flash-preview)가 읽음 | Google로 전송 |
| 문서·PDF·이미지 (헤드리스 실행) | 설정된 키를 보고 백엔드 자동 선택 | 선택된 제공사로 전송 |
헤드리스 실행의 선택 순서는 Gemini, Kimi, Claude, OpenAI, DeepSeek, Azure, Bedrock, Ollama예요. README는 Kimi를 고르면 내용이 중국 Moonshot 서버로 간다고 명시했습니다. 스킬 모드에서는 커뮤니티(하위 시스템 묶음) 이름을 붙일 때 함수·클래스 이름 목록도 호스트 모델로 넘어가요. 코드 본문은 아니지만 이름만으로도 사내 정책에 걸리는 곳이 있을 겁니다.
보안 모델은 SECURITY.md에 정리돼 있어요. 기본 MCP는 stdio이고 HTTP는 --transport http를 줄 때만 열리며 기본 바인딩은 127.0.0.1이라고 적었습니다. 소스 코드를 실행하지 않고 파싱만 하고요. 문서를 읽을 때는 파일마다 해시가 찍힌 <untrusted_source> 블록으로 감싸 프롬프트 인젝션을 줄인다고 해요. 다만 SECURITY.md 스스로 이 방어가 인젝션을 불가능하게 만들지는 않는다고 밝혔습니다.
그러니 "외부 전송 없음"이라는 말은 코드에만 해당해요. 문서와 PDF까지 넣는 순간 데이터가 어디로 가는지는 설정이 정합니다.
벡터 DB 없이 어떻게 질문에 답하나요?
질문을 단어로 쪼개 시작점을 고른 다음 그래프의 연결선을 따라가며 답을 모아요. 오픈소스 CLI 소스(serve.py)를 보면 순서가 이렇습니다.
- 질문에서 불용어를 빼고 단어를 만들어요.
- IDF 가중치와 trigram 매칭으로 시작 노드를 골라요.
- BFS(가까운 연결부터 넓게 훑는 탐색, 기본) 또는 DFS로 그래프를 따라가요.
- 기본 2,000토큰 예산 안의 텍스트로 돌려줘요.
탐색 깊이는 MCP query_graph가 기본 3이고 CLI와 /graphify query는 2로 고정이에요. 임베딩을 계산하는 코드는 패키지에서 찾지 못했습니다. 그래서 "벡터 DB 없음"은 오픈소스 CLI 기준으로 확인돼요. graphify.com FAQ에는 임베딩을 노드의 신호 하나로 저장할 수 있다는 문장이 있어서 "임베딩 없음"을 제품 전체에 적용하면 어긋납니다. BENCHMARKS.md의 메모리 벤치마크도 로컬 임베더 BGE-m3를 함께 쓴 구성이라 README의 no embeddings와 같은 조건이 아니에요.
커뮤니티 탐지도 README 기능표와 소스가 조금 다릅니다. cluster.py를 보면 Leiden은 선택 extra(graphifyy[leiden])이고, 설치돼 있지 않으면 NetworkX의 Louvain으로 대신해요. 기본 설치에서 Leiden이 돈다고 단정하면 틀립니다.
산출물은 graphify-out/ 폴더에 세 가지가 생겨요.
graph.html: 브라우저에서 보는 시각화GRAPH_REPORT.md: 핵심 노드, 커뮤니티, 추천 질문graph.json: 전체 그래프
엣지(연결선)마다 EXTRACTED(원문에 명시된 연결을 그대로 추출), INFERRED(추론), AMBIGUOUS(모호) 태그가 붙습니다. "AI가 틀린 연결을 만들면 어떻게 알아보나요?"라는 걱정에는 이 태그가 첫 단서예요. 공식 문서는 INFERRED가 항상 LLM이 만든 것은 아니라고 밝혔고, 핵심 경로는 결국 실제 코드와 대조해야 합니다.
토큰 71.5배 절감은 무엇과 비교한 숫자인가요?
파일 52개를 통째로 컨텍스트에 넣는 방식과 비교한 숫자예요. worked/karpathy-repos/review.md에 따르면 측정 대상은 Karpathy 저장소에 논문 5편과 이미지 4장을 더한 52개 파일이고, 이를 전부 넣으면 약 123,488토큰이었습니다. graphify의 질의당 평균은 약 1,726토큰이었고요. 나눠 보면 약 71.5배가 맞습니다. 측정일은 2026-04-04, 저장소 커밋은 2026-04-06이에요.
docs/how-it-works.md의 원문 표현은 "71.5x fewer tokens per query vs reading the raw files directly"입니다. 질의 하나에 드는 토큰이 원본 파일을 직접 읽을 때보다 71.5배 적다는 뜻이에요. 그런데 이 숫자를 읽을 때 봐야 할 점이 세 가지 있습니다.
- 같은 문서에서 파일 4개 코퍼스는 5.4배, 파일 6개(httpx)는 약 1배였어요. 파일이 적을수록 차이가 사라집니다.
- 토큰 수는 토크나이저 실측이 아니라 단어 수에 4/3을 곱한 추정치예요.
- 필요한 파일만 grep으로 찾아 읽는 에이전트와 비교한 수치가 아닙니다.
실제 코딩 에이전트에 가까운 비교는 BENCHMARKS.md의 ERPNext 실험(약 100만 줄, 6문항)입니다. Graphify Labs가 직접 돌린 이 실험에서 핵심 사실 커버리지는 graphify 82.0%, grep/read만 쓴 에이전트 70.8%였고 질의당 약 140K토큰이 들었어요. 이 표본은 6문항이라 작고, 재현 명령이 가리키는 memory/와 crosstool/ 디렉터리는 공개 저장소에서 확인되지 않았습니다. 같은 문서에서 LongMemEval-S는 dense RAG와 76%로 동률이에요. "벡터 RAG보다 항상 낫다"는 말은 자체 벤치마크로도 뒷받침되지 않습니다.
비용 관점에서는 이렇게 읽으면 됩니다. BENCHMARKS.md는 "Zero LLM credits to build the graph"라고 적었어요. API 키 없이 코드만 돌리면 그래프를 만드는 데 LLM 크레딧이 들지 않는다는 뜻이에요. 문서·PDF를 읽는 단계부터는 모델 호출 비용이 생기고요. 기준선 없는 절감률은 인용하지 않는 게 안전합니다. X에서는 이 도구가 아끼는 토큰만 말하고 그래프를 만들고 갱신하는 데 드는 시간은 재지 않는다는 비판이 2026-07-13에 올라왔습니다. Hacker News에서는 속도를 내세운 Rust 포트 graf(13점)가 나왔고, 한 댓글에는 저장소 15개를 매핑하는 데 graphify로 15~20분, graf로 약 5분이 걸렸다는 개인 경험담이 있어요. 반응일 뿐 근거는 아닙니다.
설치는 어떻게 하고 외부 전송은 어떻게 막나요?
명령 세 줄이면 설치되고 터미널을 열 줄만 알면 됩니다. README에 따르면 순서는 이래요. PyPI 패키지 이름은 y가 두 개인 graphifyy이고, README는 다른 graphify* 패키지와 무관하다고 경고하니 오타 설치를 조심하세요.
uv tool install graphifyy      # 또는 pipx install graphifyy
graphify install               # 어시스턴트를 감지해 스킬 등록 (Claude Code 기본)
그 뒤에는 어시스턴트 안에서 슬래시 명령으로 씁니다.
/graphify .                                  # 현재 폴더 그래프 생성
/graphify . --update                         # 바뀐 파일만 다시 추출
/graphify query "인증이 DB와 어떻게 연결되나"
/graphify path "UserService" "DatabasePool"
/graphify explain "RateLimiter"
Claude Code, Gemini CLI, Codex는 훅(도구 실행 전에 끼어드는 장치)으로 검색이나 파일 읽기 전에 그래프 질의를 유도하고, Cursor는 .cursor/rules/의 규칙 파일로 유도해요. MCP 서버는 별도 extra로 설치합니다. 설치가 Claude Code의 CLAUDE.md와 훅 설정을 고치기 때문에 미리 백업해 두세요. 설치가 CLAUDE.md의 graphify 블록 아래 내용을 지우는 회귀 보고가 2026-10-23 기준 열려 있습니다.
외부 전송을 막는 설정
보안 담당자가 가장 먼저 묻는 부분이죠. README가 안내하는 방법은 세 가지예요.
--code-only: 문서·PDF·이미지를 아예 제외합니다.GRAPHIFY_BACKEND=none: LLM 백엔드를 전부 끕니다.GRAPHIFY_BACKEND=ollama: 사내 로컬 모델로 문서를 읽게 합니다.
여기에 점검 두 가지를 붙이면 좋아요. 첫째는 셸에 어떤 API 키가 있는지 확인하는 일입니다. 키가 남아 있으면 Claude Code 안에서 돌려도 문서가 Gemini로 갈 수 있어요. 값이 화면에 찍히지 않게 이름만 보는 방법은 아래와 같습니다.
printenv | cut -d= -f1 | grep -iE 'api_key|^aws_|ollama'
둘째는 graph.json을 저장소에 커밋하기 전에 절대 경로나 사용자 이름이 들어 있는지 보는 일이에요. 과거에 노드 ID에 절대 경로가 들어가 사용자 이름이 노출된 사례가 있었고, v0.9.94도 Objective-C 쪽 비슷한 문제를 하나 고쳤습니다.
도입 전에 알아야 할 한계는 무엇인가요?
버그 보고가 많고 릴리스가 빠르다는 점이에요. 먼저 숫자 하나를 바로잡을게요. GitHub API가 돌려주는 열린 이슈 1,597은 이슈 711건과 PR 886건을 더한 값입니다(2026-10-23 조회). 이슈만 1,597건이라고 읽으면 과장이에요.
릴리스는 2026-10-13부터 2026-10-22(UTC) 사이에 6번 나왔습니다. 빠르게 고친다는 장점이지만 v0.9.94 릴리스 노트에 따르면 AST 캐시 스키마가 자주 바뀌어 업그레이드 후 첫 빌드는 전량 재추출이에요. 이슈 표본에서 눈에 띄는 대표 사례는 다음과 같습니다.
| 유형 | 내용 | 상태(2026-10-23) |
|---|---|---|
| 증분 갱신 | #3580: 증분 훅 재빌드가 변경 없는 파일 168개의 노드를 0으로 만듦 (2026-09-15 등록) | 열림 |
| 설치 부작용 | #3791: Claude 설치가 CLAUDE.md 일부를 지움 | 열림 |
| SQL 문법 | #4613: MySQL 문법의 current_timestamp() 때문에 CREATE TABLE이 통째로 빠짐 | 열림 |
| 토큰 역효과 | #3435: 훅 유도 메시지가 한 프로젝트에서 8,348회, 약 651k 토큰 주입 (2026-10-12 종료) | 종료 |
증분 갱신 버그는 --update나 git 훅으로 매일 갱신하는 팀이 특히 조심할 부분이에요. 갱신 직후에는 GRAPH_REPORT.md의 노드 수가 갑자기 줄지 않았는지 보세요. 마지막 줄의 토큰 역효과는 이미 고쳐졌지만, 토큰을 아끼려는 장치가 한때 토큰을 늘렸다는 사실은 알고 시작하는 편이 좋습니다.
한국어 질문은 어디까지 되나요?
한국어 질의 품질은 저희가 재지 않았고, 공개된 측정 자료도 찾지 못했어요. 질의 단어 분할은 공백 기준이고, 소스 기준으로 한국어 조사를 떼어 내는 형태소 분석은 없습니다. 한글 노드를 못 찾던 버그는 2026-08-11에 고쳐졌어요. 저희 추정이지만 "인증 모듈이 DB랑 어디서 만나?" 같은 문장형 질문보다 함수·클래스 이름처럼 그래프에 실제로 있는 단어를 그대로 넣는 쪽이 안전할 가능성이 큽니다. 직접 해 보고 판단하세요.
무료 오픈소스와 유료 Cloud는 무엇이 다르고 비슷한 도구와는 어떻게 다른가요?
오픈소스 CLI는 무료이고 유료 Cloud는 호스팅 제품이에요. 가격 페이지에 따르면 Free는 $0, Pro는 월 $10(연간 결제 환산, 월 결제는 $15), Teams는 좌석당 월 $20(연간 결제, 선착순 100팀 이후 $28)이며 Enterprise는 자체 호스팅 별도 견적입니다. CLI는 Apache-2.0이고 계정도 필요 없다고 FAQ가 밝혔어요. 경계는 분명합니다. 호스팅판은 연결한 저장소를 클라우드에서 그래프로 만들기 때문에 코드가 외부로 나가요. 반출이 어려운 코드라면 오픈소스 CLI나 자체 호스팅만 검토 대상입니다. 가격 페이지 하단의 SOC 2 Type II 표기는 "Engagement Started"로, 인증 완료가 아니라 착수 단계라는 뜻이에요. Cloud 홍보 문구의 절감률은 비교 기준선이 적혀 있지 않아 이 글에서는 인용하지 않았습니다.
비슷한 접근과 견주면 위치가 보여요.
| 도구 | 방식 | graphify와 차이 |
|---|---|---|
| aider repo map | aider 공식 문서에 따르면 저장소의 함수·클래스 시그니처 지도를 만들고 --map-tokens 예산(기본 1k) 안의 핵심만 매 대화 프롬프트에 포함 | graphify는 graph.json을 디스크에 남기고 에이전트가 필요한 부분만 꺼내 씀. 문서·PDF까지 한 그래프에 넣음 |
| Serena | LSP(언어 서버 프로토콜) 기반 MCP 툴킷으로 심볼 단위 검색·편집 | graphify는 tree-sitter 정적 파싱이라 INFERRED·AMBIGUOUS 태그가 붙음 |
| 벡터 임베딩 RAG | 조각을 임베딩해 질문과 비슷한 상위 조각을 가져옴 | graphify는 임베딩 없이 연결선을 따라감. 다만 자체 벤치마크에서도 LongMemEval-S는 76% 동률 |
컴파일러 수준의 정확도를 내세운 Graphify C# 같은 파생작은 Hacker News Show HN에서 46점을 받았어요. 같은 곳에서 graphify 본 저장소를 가리킨 글은 4점 이하였어요.
한국 실무에서는 어디에 쓰면 좋을까요?
설계 문서가 없거나 오래된 저장소를 처음 읽을 때 가장 쓸 만합니다. 세 가지 장면을 짚어 볼게요.
레거시 코드 인수인계
소스의 추출기 목록을 보면 COBOL, Pascal/Delphi, VB.NET, Fortran 추출기가 있어요. GRAPH_REPORT.md의 god nodes(가장 많이 연결된 핵심 모듈)와 커뮤니티로 첫 지도를 잡기에 맞습니다. 다만 VB.NET 파일 간 호출 엣지가 빠진다는 이슈가 열려 있으니 핵심 경로는 graphify path 결과를 실제 코드와 대조하세요. .inc나 .h 확장자는 .graphifyrc에 language.inc=php처럼 언어를 지정하지 않으면 엉뚱한 언어로 파싱될 수 있고, README는 이때 오류도 나지 않는다고 적었습니다.
큰 저장소 온보딩
코드만 있는 저장소는 API 키 없이 로컬에서 시작하니 문턱이 낮아요. 대형 모노레포에서 파일 분류 단계가 35분 넘게 걸렸다는 보고가 있었고 2026-08-25에 종료됐습니다. 빌드 산출물과 의존성 폴더는 .graphifyignore나 --exclude로 먼저 빼 두세요.
SQL 스키마 파악
graphifyy[sql] extra를 설치하면 테이블, 뷰, 함수, 외래키, JOIN 관계를 결정론으로 뽑습니다. v0.9.94부터는 저장 프로시저가 읽고 쓰는 테이블 엣지와 T-SQL의 GO 구분자도 처리해요. --postgres DSN으로 운영 DB 스키마를 직접 읽는 extra도 있습니다. MySQL 문법 일부에서 테이블이 통째로 빠지는 버그는 열려 있으니 테이블 수를 따로 세어 대조하세요.
사내 설계 문서와 PDF, ADR까지 한 그래프로 묶을 수도 있어요. 이 부분은 LLM이 읽기 때문에 비용이 들고 외부 전송이 생깁니다. 위에서 본 차단 설정부터 정한 뒤에 넣으세요.
마무리
graphify는 AI 에이전트에게 저장소 배선도를 주는 도구이고, 코드 쪽은 로컬 파싱이라 문턱이 낮아요. 문서와 PDF는 LLM을 거치고, 71.5배 절감은 파일 52개를 통째로 넣는 방식 대비 수치라는 점이 핵심입니다. 증분 갱신과 설치 부작용 같은 열린 버그도 있어서 팀 전체에 깔기 전에 작은 저장소에서 확인하는 편이 좋아요.
우리 팀 상황에 맞는지부터 따져보셔도 충분합니다. 판단에 필요한 기준은 위에 정리해 뒀어요. 첫걸음으로는 코드만 있는 작은 저장소 하나에 --code-only로 돌려 보고, GRAPH_REPORT.md의 핵심 노드가 실제 구조와 맞는지 대조해 보세요.
자주 묻는 질문
코드만 있는 저장소도 API 키가 필요한가요?
필요 없어요. README에 따르면 코드 파일은 tree-sitter로 로컬에서 파싱하고 LLM을 부르지 않기 때문에 코드만 있는 저장소는 API 키 없이 그래프가 만들어집니다. 기본 설치의 tree-sitter 문법은 25종이고 SQL 등은 graphifyy[sql] 같은 extra를 따로 설치해야 해요.
Claude Code 안에서 돌려도 문서가 Google로 갈 수 있다는 게 사실인가요?
사실이에요. 스킬 문서에 따르면 셸에 GEMINI_API_KEY나 GOOGLE_API_KEY가 있으면 문서·PDF를 읽는 단계가 기본 모델 gemini-3-flash-preview를 통해 Google로 전송됩니다. 실행 전에 키 이름을 확인하고, 막으려면 --code-only나 GRAPHIFY_BACKEND=none을 쓰세요.
벡터 RAG보다 항상 정확한가요?
그렇게 말할 근거는 없어요. BENCHMARKS.md의 ERPNext 실험(6문항)에서 graphify는 grep/read 에이전트 대비 핵심 사실 커버리지가 82.0% 대 70.8%였습니다. 하지만 LongMemEval-S는 dense RAG와 76%로 동률이고, 모두 Graphify Labs가 직접 돌린 결과예요.
한국어로 질문해도 잘 찾아 주나요?
아직 확인된 바가 없습니다. 소스 기준으로 질의 단어 분할은 공백 기준이고 한국어 조사 분리는 없어요. 한글 노드를 못 찾던 버그는 2026-08-11에 수정됐지만 한국어 질의 품질을 잰 자료는 찾지 못했습니다.
그래프가 틀린 연결을 만들었는지 어떻게 알 수 있나요?
엣지에 붙은 태그를 보세요. 원문에 명시돼 그대로 뽑은 연결은 EXTRACTED, 추론은 INFERRED, 모호한 연결은 AMBIGUOUS로 표시됩니다. 공식 문서는 INFERRED가 항상 LLM 산출물은 아니라고 밝혔으니, 중요한 경로는 graphify path 결과를 실제 코드와 대조해 확인하세요.
팀이 쓰려면 유료 Cloud를 꼭 써야 하나요?
아니요. 가격 페이지 FAQ에 따르면 오픈소스 CLI는 Apache-2.0 무료이고 계정이 필요 없습니다. Cloud는 Free $0 플랜과 Pro 월 $10(연간 결제 환산)부터의 유료 플랜을 둔 호스팅 제품이며 코드가 외부 클라우드로 가요.