Anthropic Mythos 유출 주장 모델, 진짜일까요? 허깅페이스 numbat 분석 (2026 기준)
 퀀텀점프클럽 정상록17분 읽기5 views
무료 자료
PDF · 무료
출처 모를 AI 모델, 받기 전에 뭘 확인할까요?
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
Anthropic Mythos 유출 주장 모델, 진짜일까요? 허깅페이스 numbat 분석 (2026 기준)
Mythos 유출이라는 numbat 저장소의 일부 텐서(숫자 묶음)는 이름만으로 만든 난수와 일치합니다. 분석가들은 학습된 가중치로 보기 어렵다고 봅니다. 재생성된 것은 텐서 1,576,410개 중 635개예요.
한 줄 답: Anthropic 모델이 맞다는 근거는 아직 없고, 분석가들은 이 파일을 학습된 가중치(모델이 학습으로 얻은 숫자 묶음)로 보기 어렵다고 판단했어요. 다만 일치가 확인된 범위는 텐서 635개와 4비트 행렬의 부호 표본까지라서 전체가 난수라는 단정은 아직 이릅니다. 출처 모를 모델은 trust_remote_code(저장소에 든 코드를 내 컴퓨터에서 실행해도 된다고 허락하는 설정)를 꺼 둔 채로 확인하는 편이 안전해요.
Mythos 유출 주장, 왜 이렇게 빨리 퍼졌나요?
결론부터 말하면 numbat 저장소를 Anthropic 모델의 유출로 볼 근거는 지금까지 나오지 않았어요. 분석가들은 올라온 파일의 일부를 학습된 숫자가 아니라고 판단했습니다.
이런 질문이 먼저 떠오르실 거예요. "이거 진짜 Anthropic 모델 아니야?" "7.72TB나 되는데 받아서 돌려 봐도 되나?" 거대한 모델 파일이 눈앞에 있다는 말을 들으면 궁금해지는 게 당연합니다.
발단은 2026-10-23 허깅페이스(Hugging Face, AI 모델 파일을 공유하는 사이트)에 만들어진 저장소 하나예요. CellCog는 2026-11-01 14:53 UTC에 올라온 X 사용자 @OxShamss의 게시물을 확산 계기로 꼽았습니다. 허깅페이스 토론은 2026-10-31 21:35 UTC부터 이미 열려 있었고요.
이 글은 저장소에 실제로 무엇이 있었는지, 분석가들이 무엇을 어디까지 재현했는지, Anthropic과 허깅페이스의 반응은 어땠는지를 차례로 봅니다. 마지막에는 Mythos 유출 같은 주장이 올라왔을 때 파일을 받기 전에 확인할 순서를 정리해요.
허깅페이스에 무엇이 올라왔나요?
허깅페이스 공개 API를 2026-11-03 07:12 KST에 조회한 값으로 보면, 저장소 burner22/numbat은 2026-10-23 01:37 UTC에 만들어졌고 마지막 파일 변경은 2026-10-24 19:09 UTC였어요. 올린 계정은 2026-10-16 05:58 UTC에 생긴 익명 계정입니다. 이 계정이 올린 모델은 numbat 하나뿐이고 조직 소속도 없어요.
파일은 784개입니다. 가중치를 조각으로 나눈 샤드(shard) 772개에 설정 파일, 코드 파일, 토크나이저가 붙어 있어요. 샤드 1개가 약 10GB이고 전체는 7.72TB예요. 이 값은 10진수 기준이라 2진수 기준으로는 약 7.02TiB입니다.
저장소 소개글(모델 카드)에서 업로더는 이렇게 주장해요. "Internal codename numbat, Anthropic's next Mythos-class training run." Anthropic의 차기 Mythos급 학습 실행이라는 뜻입니다. 출처를 묻는 사람에게는 "Mirrors welcome. Do not DM me asking for the source."라고 적어 두었어요. 미러는 환영하지만 출처를 묻는 DM은 받지 않겠다는 말이에요. FAQ의 "Is this real?"에는 "Yes."라고 답했습니다.
학습 중간 체크포인트(학습 도중 저장한 모델 상태)와 평가 점수도 파일에 적혀 있어요. 하지만 업로더가 올린 메타데이터 파일에만 있는 값이고 외부에서 검증할 수단이 없어서, 이 글에서는 점수를 옮기지 않습니다.
14조 파라미터 주장은 숫자로 가릴 수 있나요?
업로더는 모델 카드에 약 14조 파라미터(모델이 가진 조절 숫자의 개수)라고 적었어요. 그런데 허깅페이스 API의 자동 집계는 6,849,378,030,158개, 약 6.85조입니다. "14조라더니 절반이네, 거짓말이네" 하고 읽기 쉬운 대목이에요.
기준이 달라서 생긴 차이입니다. 6.85조는 4비트 값 2개를 1개로 센 패킹 기준이에요. 같은 API의 데이터형별 합은 13,681,899,638,232개로 약 13.68조인데, 4비트 값을 풀어서 센 기준입니다. ressl도 토론 #31에서 같은 13.68조를 계산했어요. 파라미터 수 차이만으로는 진위가 갈리지 않는다는 뜻이에요.
114층, 전문가 1,224개 중 48개 선택 같은 구조 설명도 마찬가지예요. config.json에 그렇게 적혀 있다는 사실이 확인됐을 뿐입니다. 설정 파일이 주장과 맞는다고 해서 누가 만든 파일인지가 증명되지는 않아요. Anthropic과 연결되는 서명이나 해시 같은 암호학적 근거도 없다고 explainx는 지적했습니다.
이름표 난수 분석은 무엇을 보여 줬나요?
쉬운 비유부터 들게요. 진짜로 학습된 가중치는 수없이 고쳐 쓴 연습장 같아서, 이름표만 넣고 똑같은 숫자를 다시 찍어 낼 수 없어요. 그런데 이 파일의 일부는 텐서 이름만 넣으면 같은 숫자가 다시 찍혀 나오는 난수표였다는 게 분석의 요지입니다.
사용자 FloxUnder가 2026-11-01 16:29 UTC 허깅페이스 토론 #13에 공개한 방법은 이렇습니다. 텐서 이름을 SHA-256 해시 함수로 지문처럼 바꾸고, 앞 8바이트를 난수 생성기의 씨앗(시드)으로 써요. 거기서 뽑은 정규분포 난수를 정규화 텐서는 exp(0.06×z), 합성곱 텐서는 z×1/6으로 바꾼 뒤 BF16 형식으로 반올림합니다. 이렇게 이름만으로 만든 값이 파일 속 값과 같은지 비교해요.
| 확인한 사람 | 범위 | 결과 |
|---|---|---|
| FloxUnder(토론 #13, 2026-11-01 16:29 UTC) | 텐서 43개, 값 730,368개 | 전부 일치. 읽기 전에 예측을 적어 둔 텐서 21개도 일치 |
| CellCog(블로그, 2026-11-01 20:18 UTC) | 샤드 1의 텐서 9개 | 9개 중 9개 일치. 시드를 바꾼 대조군은 불일치 |
| ressl(토론 #31, 2026-11-02 10:08 UTC) | 전체 784개 파일(약 7.02TiB) | 정규화 377개 중 377개, 합성곱 258개 중 258개 일치. 4비트 행렬은 부호 비트 표본 1억 9,200만 개 원소 일치 |
| QJC 리서치(2026-11-03 07:16 KST) | 샤드 1의 텐서 5개 | 5개 중 5개 바이트 단위 일치. 이름을 1글자 바꾼 대조군은 0.09~2.6%만 일치 |
ressl의 게시물은 같은 날 17:49 UTC에 정정이 붙었어요. 우리 확인은 샤드 1의 헤더와 텐서 5개만 받아서 비교했고, 저장소 코드는 실행하지 않았습니다.
범위는 꼭 같이 읽어야 해요. 정확히 재생성된 것은 텐서 개수 기준으로 1,576,410개 중 635개(정규화 377개와 합성곱 258개)입니다. 이 비율을 용량이나 파라미터 비율로 바꿔 읽으면 안 돼요. 덩치가 큰 4비트 행렬은 부호 비트 표본이 일치한 데까지만 확인됐습니다. ressl은 한계를 이렇게 적었어요. "I cannot regenerate the magnitudes, the FP4 payload as a whole, or the checkpoint." 크기값, 4비트 데이터 전체, 체크포인트 전체는 재생성하지 못한다는 뜻이에요.
FloxUnder도 토론 #13에서 선을 그었습니다. "These matches alone cannot logically exclude a training setup that deliberately kept all these parameters frozen." 이 일치만으로는 해당 파라미터를 일부러 고정한 채 학습한 경우를 논리적으로 배제할 수 없다는 말이에요. 토론 #13의 ignis-sec 댓글은 일부 텐서가 이 방법과 맞지 않아서 다른 방법이나 덧붙인 노이즈일 수 있다고 적었어요.
그래서 쓸 수 있는 문장은 하나입니다. 분석가들은 이 파일을 학습된 가중치로 보기 어렵다고 판단했어요. "전부 난수", "가짜로 확인"이라는 단정은 아직 전수 증명된 적이 없습니다.
Anthropic과 허깅페이스는 뭐라고 했나요?
Anthropic은 2026-11-03 07:17 KST 기준으로 anthropic.com의 news, claude/mythos, glasswing, claude-fable-and-mythos-5-1 네 페이지에 numbat이나 유출 관련 공지를 올리지 않았어요. 네 페이지에서 "numbat"과 "leak"은 각각 0건이었습니다. 이건 공지가 없다는 사실만 확인한 것이라, Anthropic이 무언가를 밝혔다거나 밝히지 않았다고 단정하지는 않아요. 공식 X 계정은 로그인 없이 목록을 받을 방법이 없어서 확인하지 못했습니다.
허깅페이스 쪽은 2026-11-03 07:19 KST 기준 저장소가 공개 상태 그대로였어요. 토론 42건 가운데 허깅페이스 직원 표시가 있는 댓글은 없었고, 신고 토론은 여러 건 열려 있었습니다. Hacker News에서는 스토리 하나의 본문이 "URL deleted for malware concerns."로 바뀌었는데, 누가 바꿨는지는 확인되지 않았어요.
Mythos가 어떤 모델인지도 짚어 둘게요. Anthropic 공식 Glasswing 페이지에 따르면 Anthropic은 2026-04-07 Project Glasswing을 발표하며 Claude Mythos Preview를 공개 출시하지 않은 범용 프런티어 모델로 소개했어요. 현재 공식 Mythos 페이지는 Claude Mythos 5.1(2026-09-01 발표)이고, 검증된 사이버 방어·생명과학 기관에만 제공된다고 적혀 있습니다. 같은 페이지는 Claude Fable 5.1이 Mythos 5.1과 같은 기반 모델에 안전장치를 더해 일반 제공된다고 설명해요. 이번에 확인한 공식 페이지 4곳에는 가중치 공개 언급이 없었습니다.
numbat이라는 이름은 MACCUS가 VentureBeat 보도를 인용해 전한 내용이 있어요. 2026-03-31 Claude Code 2.1.88 npm 배포 사고 때 Numbat이 미출시 모델의 코드명으로 드러났다는 겁니다. 2차 자료이고 원문은 확인하지 못했어요. 코드명이 실재한다 해도 이 파일의 출처를 증명하지는 않습니다.
trust_remote_code는 왜 위험한가요?
이 저장소는 태그에 custom_code가 달려 있고, README가 AutoModelForCausalLM.from_pretrained(..., trust_remote_code=True)로 불러오라고 안내해요. trust_remote_code는 모델 파일과 함께 온 코드 파일을 확인 없이 내 컴퓨터에서 실행해도 된다고 허락하는 스위치와 비슷합니다.
transformers 공식 문서의 인자 설명은 분명해요. "This option should only be set to True for repositories you trust and in which you have read the code, as it will execute code present on the Hub on your local machine." 신뢰하고 코드를 직접 읽은 저장소에서만 True로 두라는 뜻이고, 기본값은 False입니다. 같은 문서 계열의 Custom models 절은 이렇게도 적어요. "Take extra precaution when loading a custom model. While the Hub includes malware scanning for every repository, you should still be careful to avoid inadvertently executing malicious code." 허브가 악성코드 스캔을 해도 방심하지 말라는 당부예요. 같은 절은 바뀌었을 수 있는 코드를 불러오지 않도록 특정 리비전(커밋 해시)에서 로드하라고도 권합니다.
허깅페이스의 스캔 표시도 조심해서 읽어야 해요. 2026-11-03 07:19 KST 기준 이 저장소의 보안 스캔 필드는 scansDone이 true, 문제 파일 0개였습니다. 그런데 허깅페이스 악성코드 스캔 문서는 "We run every file of your repositories that is smaller than 2 GB through a malware scanner."라고 적어요. 2GB보다 작은 파일만 검사한다는 말이에요. 이 저장소의 샤드 1은 10,006,339,128바이트라서, 샤드가 검사 대상이었는지는 문서만으로 알 수 없습니다. 이 표시를 안전 보증으로 읽으면 안 돼요.
가중치 파일 형식도 같이 볼게요. pickle(파이썬 객체를 저장하는 형식)은 불러올 때 임의 코드를 실행하는 공격이 가능하다고 허깅페이스 문서가 설명하고, 대안으로 safetensors를 소개해요. 이 저장소의 가중치는 safetensors 형식입니다. 하지만 저장소에 같이 온 modeling 코드 파일은 별개라서 trust_remote_code 문제는 그대로 남아요.
우리는 리비전 6b7f8fc의 modeling_numbat.py(22,280바이트)와 configuration_numbat.py(3,166바이트)를 실행하지 않고 텍스트로만 읽었습니다. import는 math, typing, torch, transformers와 같은 폴더의 설정 파일뿐이었고, 네트워크 호출, 외부 프로세스 실행, 파일 쓰기, 동적 코드 실행은 없었어요. 이 결과는 그 판본 하나에만 해당합니다. 저장소 주인은 언제든 파일을 바꿀 수 있고, 리비전을 고정하지 않으면 다음 로드 때 다른 코드가 실행될 수 있어요.
낯선 모델은 받기 전에 어떤 순서로 확인하나요?
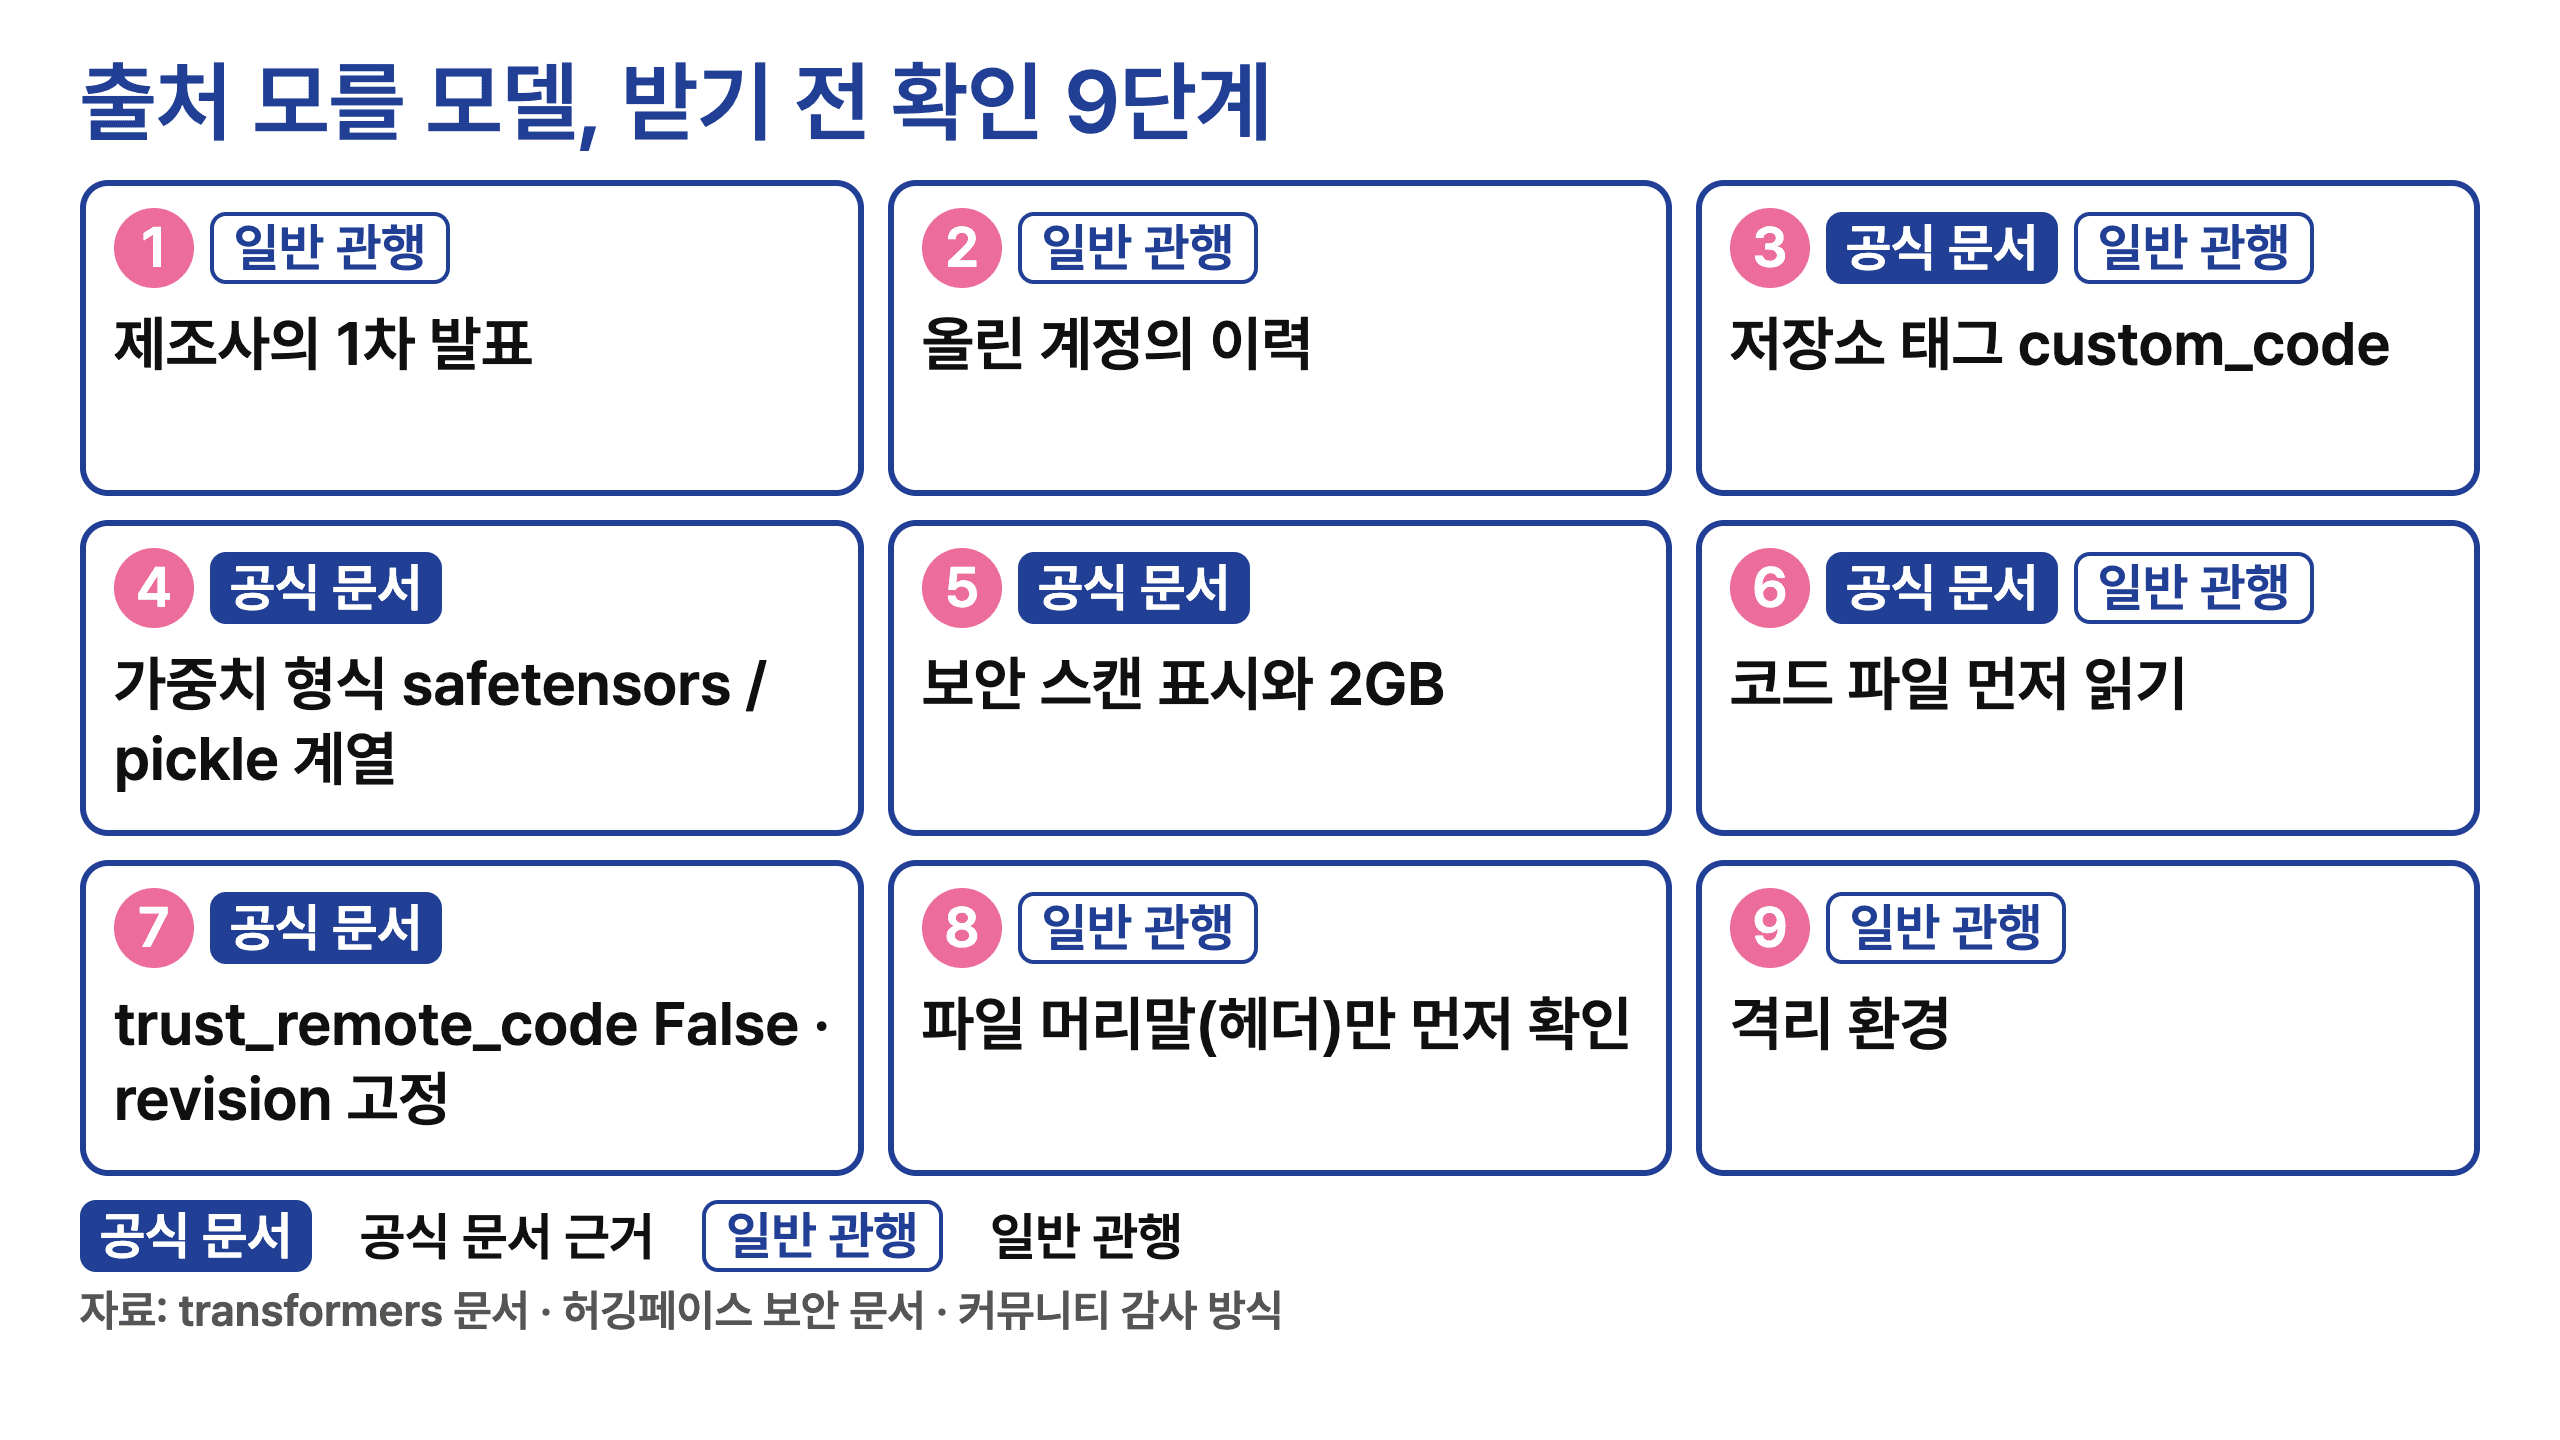
AI 모델 보안은 거창한 도구보다 받기 전 확인 습관에서 갈려요. 아래 9단계에는 공식 문서에 근거가 있는 항목과 일반적인 보안 관행을 구분해 표시했습니다.
낯선 모델은 받기 전에 어떤 순서로 확인하나요?
출처 모를 모델, 받기 전 확인 9단계
자료: huggingface.co · QJC 재구성
- 제조사의 1차 발표가 있는지 봅니다. 공식 블로그나 공식 조직 계정이 대상이에요. (일반 관행. 이번 건은 없음)
- 올린 계정의 이력을 봅니다. 생성일, 다른 모델 수, 조직 소속이에요. (일반 관행. 이번 건은 2026-10-16 생성, 모델 1개)
- 저장소 태그에 custom_code가 있는지 봅니다. 있으면 trust_remote_code를 요구해요. (이유는 transformers 문서, 확인 방법은 일반 관행)
- 가중치 형식이 safetensors인지, .bin·.pt·.pkl 같은 pickle 계열인지 봅니다. (허깅페이스 pickle 문서)
- 파일별 보안 스캔 표시를 보고, 2GB가 넘는 파일이 있는지 따져요. 문서상 악성코드 스캐너는 2GB보다 작은 파일을 검사합니다. (허깅페이스 악성코드 스캔 문서)
- modeling_*.py 같은 코드 파일을 웹 화면에서 먼저 직접 읽습니다. (코드를 읽으라는 말은 transformers 문서, 웹에서 읽는 방법은 일반 관행)
- trust_remote_code는 기본값 False로 둡니다. 꼭 켜야 하면 읽은 코드의 커밋 해시로 revision을 고정해요. (transformers 문서)
- 테라바이트급 저장소는 전부 받기 전에 파일 머리말(헤더)만 먼저 확인할 방법이 있는지 살펴봅니다. (일반 관행, CellCog와 토론 #13이 쓴 방식)
- 실행이 꼭 필요하면 네트워크와 자격증명이 없는 격리 환경에서 합니다. (일반 보안 관행. 허깅페이스 문서의 문장은 아니라서 공식 권고라고 부를 수 없어요)
이번 numbat 건에 대입하면 1번에서 이미 걸려요. 제조사 발표가 확인되지 않았습니다. 3번에서는 custom_code 태그와 trust_remote_code=True 안내가 보이고, 5번에서는 샤드가 약 10GB라 스캔 표시를 믿기 어려워요.
마무리
정리하면 이렇습니다. numbat 저장소가 Anthropic 모델이라는 근거는 아직 없고, 분석가들은 학습된 가중치로 보기 어렵다고 판단했어요. 다만 재현된 범위는 텐서 1,576,410개 중 635개와 4비트 행렬의 부호 표본까지입니다. 이 한계를 함께 기억하면 "진짜다"와 "전부 가짜다" 두 단정을 모두 피할 수 있어요.
Mythos 유출이라는 말은 이번 한 번으로 끝나지 않을 거예요. 앞으로도 출처 불명의 큰 모델이 올라올 때마다 같은 질문을 하게 됩니다.
- 지금 쓰는 모델 저장소를 올린 계정은 누구이고 이력이 있나요?
- trust_remote_code를 켠 코드 중 직접 읽어 본 것이 있나요?
- revision은 고정해 두었나요?
우리 팀 상황에 맞는지부터 따져보셔도 충분해요. 판단에 필요한 기준은 위에 정리해 뒀으니, 질문 세 개를 하나씩 점검해 보세요.
자주 묻는 질문
numbat 저장소는 Anthropic이 올린 게 맞나요?
맞다는 근거는 아직 없어요. 올린 계정 burner22는 2026-10-16에 만들어진 익명 계정이고 모델은 numbat 하나, 조직 소속도 없습니다. Anthropic과 연결되는 서명이나 해시도 없었고, 2026-11-03 07:17 KST에 확인한 공식 페이지 4곳에도 관련 공지가 없었어요.
허깅페이스 보안 스캔에서 문제 파일이 0개면 안전한 거 아닌가요?
그렇게 읽으면 안 돼요. 허깅페이스 악성코드 스캔 문서는 2GB보다 작은 파일을 스캐너로 검사한다고 적고, numbat 샤드는 개당 약 10GB입니다. 2026-11-03 07:19 KST 기준 필드에 문제 파일 0개로 표시돼도 샤드가 검사됐는지는 문서만으로 알 수 없어요.
약 14조라더니 6.85조면 거짓말 아닌가요?
그 숫자만으로는 판단할 수 없어요. 허깅페이스 자동 집계 6.85조는 4비트 값 2개를 1개로 센 기준이고, 풀어서 세면 약 13.68조입니다. ressl도 토론 #31에서 같은 13.68조를 계산했어요.
trust_remote_code=True는 언제 켜도 되나요?
코드를 직접 읽고 신뢰하는 저장소에서만 켜세요. transformers 공식 문서는 기본값이 False이고, 허브의 코드를 내 컴퓨터에서 실행하기 때문에 신뢰하고 읽은 저장소에만 True를 쓰라고 안내해요. 켜야 한다면 읽은 코드의 커밋 해시로 revision을 고정하는 것은 transformers의 Custom models 문서가 권하는 방법입니다.
파일 전체가 가짜로 확인된 건가요?
아직 그렇게 단정하지 못해요. 재생성이 확인된 것은 텐서 1,576,410개 중 635개이고, 4비트 행렬은 부호 비트 표본까지입니다. ressl은 크기값과 체크포인트 전체는 재생성하지 못한다고 밝혔고, FloxUnder도 일부러 고정한 채 학습한 경우를 배제할 수 없다고 적었어요.
참고 자료
- 허깅페이스 토론 #13, FloxUnder의 시드 난수 감사
- 허깅페이스 토론 #31, ressl의 전체 784개 파일 감사
- CellCog, Mythos 유출 주장 재현 글
- MACCUS, Claude Mythos 유출 주장 정리
- transformers AutoModel 문서(trust_remote_code)
- transformers Models 문서(Custom models)
- 허깅페이스 Hub 악성코드 스캔 문서
- 허깅페이스 Hub pickle 스캔 문서
- Anthropic 공식 Mythos 페이지
- Anthropic 공식 Glasswing 페이지
- burner22/numbat 저장소 첫 화면