TradingAgents 써도 될까요? AI 토론 구조와 v0.7.0 변경점, 한계까지 2026 정리
 퀀텀점프클럽 정상록21분 읽기5 views
무료 자료
PDF · 무료
AI 애널리스트들의 모의 토론, 어디까지 믿어도 될까요?
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
TradingAgents 써도 될까요? AI 토론 구조와 v0.7.0 변경점, 한계까지 2026 정리
요즘 자꾸 보이는 TradingAgents, 정체가 뭔가요?
TradingAgents는 증권사 리서치 조직을 흉내 낸 오픈소스(코드가 공개된 프로그램)예요. 에이전트(역할을 맡아 일하는 AI 프로그램) 여럿이 애널리스트·트레이더·리스크 담당으로 나뉘어 토론하고, 한 종목에 대한 의견 보고서를 내놓습니다.
요즘 자꾸 보이는 TradingAgents, 정체가 뭔가요?
이미지 출처: github.com
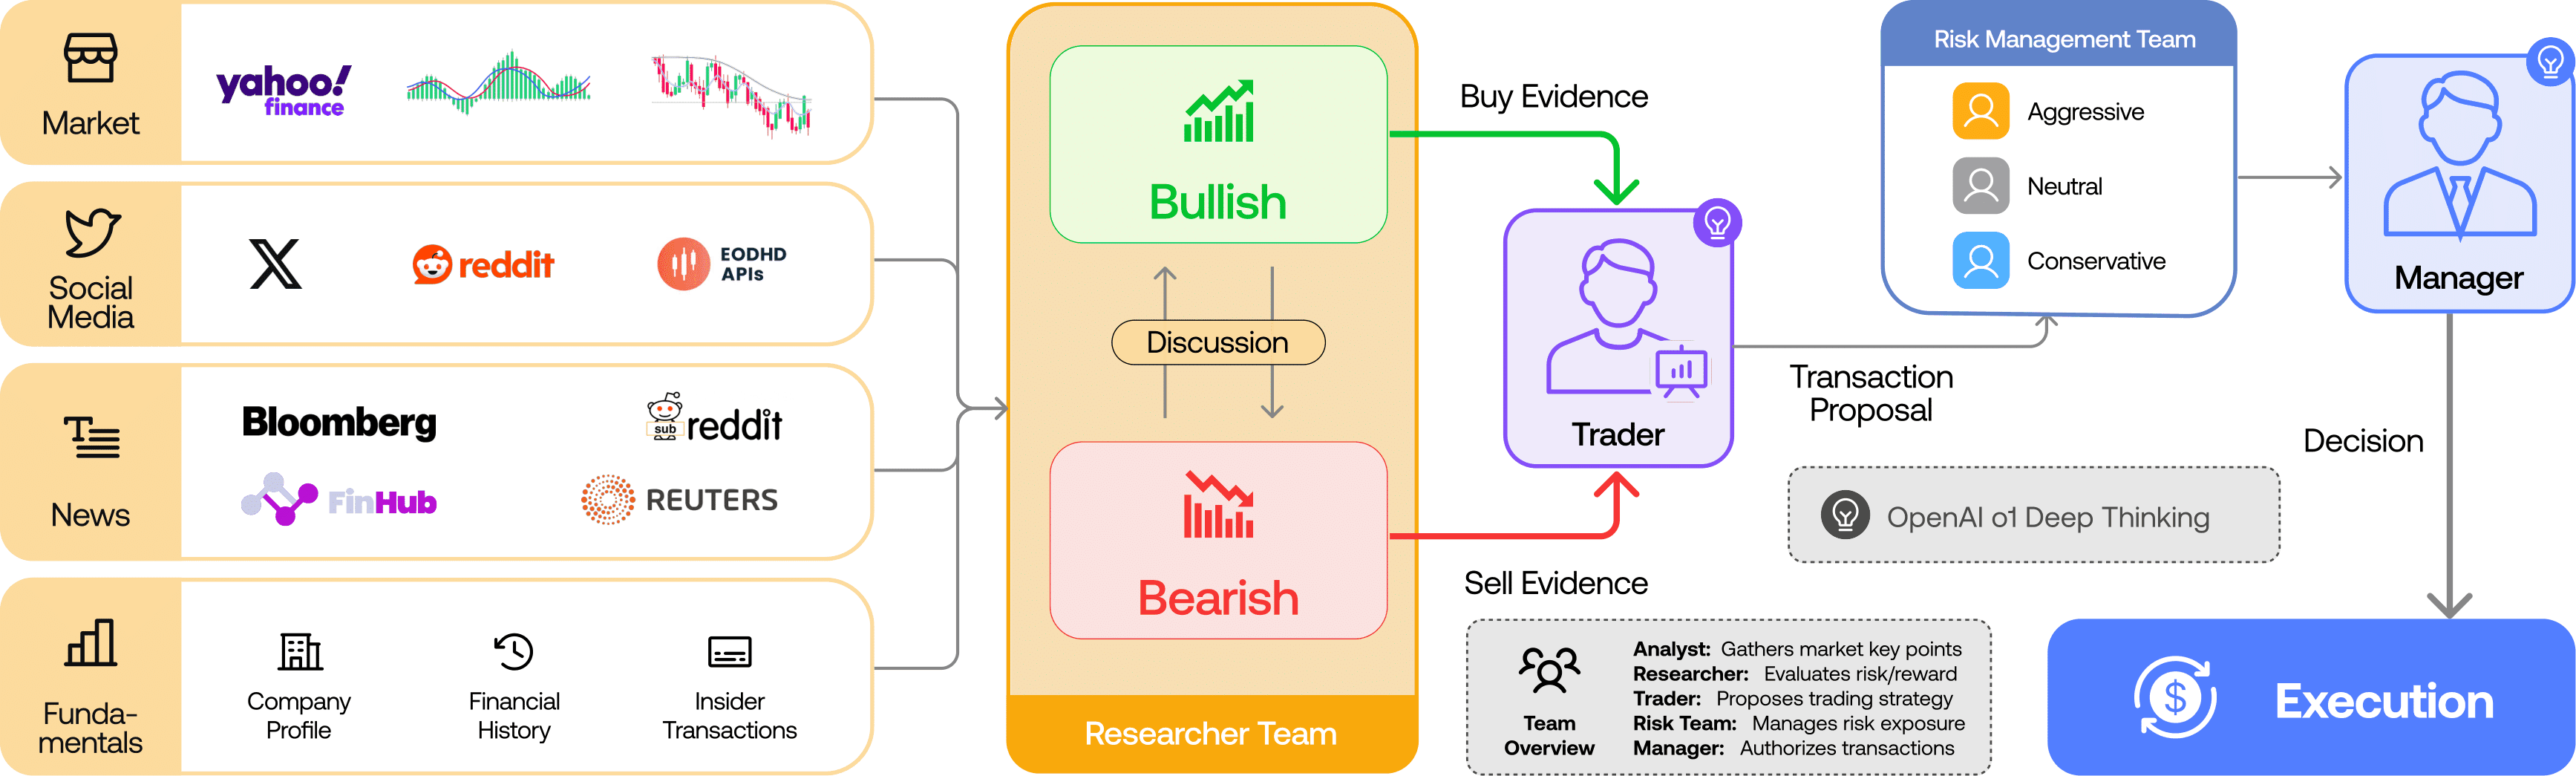
도식 오른쪽 아래 Execution 상자를 README는 모의 거래소 체결로 설명하지만, 소스에서 거래소 모듈은 확인되지 않았어요. 실제 동작은 결정을 기록해 뒀다가 나중에 실제 종가로 채점하는 방식이고, 증권사로 주문을 보내는 경로도 없어요. 도식 속 모델 이름(OpenAI o1)과 데이터 공급원 로고는 논문 시기 구성이라 지금 기본값과 달라요.
"AI끼리 회의해서 종목 의견을 낸다던데 그걸 믿어도 되나요?" 별이 많은 도구라서 이런 질문이 먼저 떠오르는 게 자연스러워요. 이 글은 투자 권유가 아니라 도구 설명입니다. 구조, 결과물, 2026-10-16 공개된 v0.7.0 변경점, 한국 종목 범위, 리서치 보조로 쓰는 순서와 한계를 차례로 짚어 볼게요.
규모부터 볼까요. TauricResearch/TradingAgents 저장소는 2026-10-26 GitHub API로 측정한 값이 별 115,084개, 포크(복제본) 22,173개이고 라이선스는 Apache-2.0이에요. 같은 계열로 자주 비교되는 virattt/ai-hedge-fund는 같은 날 측정에서 별 64,262개, 라이선스는 MIT였어요. 논문 저자 4명의 소속 표기에는 UCLA, MIT, Tauric Research가 들어 있지만 대학이 공식으로 만든 도구라는 근거는 확인되지 않았습니다.
에이전트들은 어떤 순서로 토론하고 무엇을 내놓나요?
증권사 회의실을 통째로 흉내 낸 모의 회의라고 보면 쉬워요. 분석가들이 보고서를 올리면 낙관론자와 비관론자가 맞서고, 트레이더가 안을 내면 리스크팀이 다시 따진 뒤 책임자가 등급을 매깁니다. 회의록은 남지만 주문 버튼은 없는 회의예요.
이런 구조를 멀티 에이전트(여러 AI가 역할을 나눠 협업하는 방식)라고 불러요. README와 소스 코드(graph/setup.py)에 따르면 흐름은 아래와 같고, 기반은 LangGraph(여러 AI 단계를 흐름도처럼 이어 주는 파이썬 도구)입니다.
| 순서 | 역할 | 하는 일 |
|---|---|---|
| 1 | 애널리스트 4종 | 시장·기술 지표, 감성(분위기), 뉴스, 펀더멘털(재무제표) 보고서를 동시에 작성 |
| 2 | 강세·약세 리서처 | 보고서를 놓고 낙관 쪽과 비관 쪽이 번갈아 토론 |
| 3 | 리서치 매니저 | 토론을 정리해 투자 계획 작성 |
| 4 | 트레이더 | 언제 얼마나 사고팔지 안을 제안 |
| 5 | 리스크 토론자 3명 | 공격적·보수적·중립 관점에서 트레이더 안을 재검토 |
| 6 | 포트폴리오 매니저 | 최종 등급 결정 |
기본 설정(default_config.py)에서는 강세·약세 토론이 1회라서 두 리서처가 한 번씩 총 2번 발언한 뒤 다음 단계로 넘어가요. 리스크 토론도 세 명이 1회씩 발언합니다. CLI(명령어로 쓰는 실행 화면)에서 리서치 깊이를 Shallow로 두면 토론 1회, Medium은 3회, Deep은 5회예요. 모델은 두 등급으로 나뉘는데 프로젝트 설정 설명은 "The quick model serves the analysts, researchers, debaters and trader; the deep model serves the research and portfolio managers."입니다. 빠른 모델이 대부분을 맡고 깊이 생각하는 모델이 두 매니저를 맡는다는 뜻이에요.
TradingAgents란: 애널리스트, 강세·약세 리서처, 트레이더, 리스크 토론자, 포트폴리오 매니저 역할을 나눈 LLM(ChatGPT 같은 글 생성 AI) 에이전트들이 토론해 5단계 등급과 근거 보고서를 내는 오픈소스 프레임워크예요. 실제 주문은 내지 않습니다.
주문도 대신 넣어 주나요?
아니요. 최종 출력은 Buy, Overweight, Hold, Underweight, Sell 5단계 등급과 근거 보고서예요. 등급을 읽을 수 없으면 Hold로 바꾸지 않고 REVIEW로 표시합니다(rating.py). 보고서는 Markdown 문서이고 v0.6.0부터 한 페이지짜리 HTML도 나와요.
주문 기능이 없다는 근거는 세 가지예요(2026-10-26 조사 기준).
- pyproject.toml에 적힌 의존성 19개는 langchain, langgraph, yfinance, pandas 같은 분석용이고 증권사 연동 도구(SDK)가 없어요.
- 소스 전체에서 broker, alpaca, ib_insync, place_order, submit_order를 검색하면 증권사식 티커 표기를 야후 표기로 바꾸는 주석만 걸려요.
- 보유 종목 입력 모듈 portfolio.py가 스스로 "nothing here implies a venue or an execution path"라고 적어요. 거래소나 주문 경로를 암시하는 코드가 없다는 말이에요.
README에는 주문을 "simulated exchange"로 보낸다는 문장이 남아 있어요. 그런데 소스에서 거래소 모듈은 확인되지 않았습니다. 실제 동작은 결정을 기록해 뒀다가 보유 기간이 지나면 실제 종가로 수익률을 채점하는 방식이에요.
프로젝트 스스로 선을 긋기도 해요. README는 "TradingAgents framework is designed for research purposes."라고 적고 "It is not intended as financial, investment, or trading advice."라고 덧붙입니다. Tauric Research 약관(2026-10-23 시행)도 "Nothing in the Services is investment, financial, legal, tax, or accounting advice"라고 밝혀요.
v0.7.0에서 뭐가 달라졌나요?
2026-10-16 공개된 v0.7.0 릴리스 노트 첫 줄 요약에는 변경점이 네 가지 꼽혀 있어요. 눈여겨볼 건 두 가지입니다.
ChatGPT 구독으로 돌릴 수 있어요
릴리스 노트는 "runs TradingAgents on a ChatGPT Plus or Pro plan instead of an API key"라고 적어요. API 키 대신 ChatGPT Plus·Pro 구독으로 실행한다는 말입니다. OpenAI가 오픈소스 앱용으로 문서화한 "Sign in with ChatGPT" 방식을 따르는데, OpenAI 문서에는 요금제 이름 Plus·Pro가 나오지 않아요. 이 표기는 TradingAgents 쪽 설명입니다. OpenAI 문서는 이 기능을 "ChatGPT plan usage is an optional capability within Sign in with ChatGPT."라고 소개해요.
실행은 구독 사용량 한도에서 차감되고 temperature와 max_tokens 설정은 쓸 수 없어요. 구독료가 사라지는 게 아니라 API 요금 대신 구독 한도를 쓰는 방식입니다. CLI에서 Subscription을 고르거나 tradingagents login chatgpt로 한 번 로그인하면 돼요.
채점 시점 오류를 고쳤어요
TradingAgents는 결정을 기록해 두고 나중에 실제 종가로 채점해요. 결정일을 d라고 하면 d의 장 마감 뒤에 나온 뉴스도 그날 분석에서 읽을 수 있는데, 종전에는 d의 종가부터 채점했습니다. 시장이 그 뉴스에 반응하는 날은 d 다음 거래일이에요. v0.7.0 노트는 "A decision is no longer scored against news it could not have traded on"이라며 d 다음 첫 종가부터 채점하도록 바꿨다고 설명합니다.
이슈 #1518(2026-10-13 등록)을 올린 사용자의 분석 기준으로 2015년부터 2026년까지 미국 대형주 84개의 실적 발표 공시(8-K, 중요 사건을 알리는 수시 공시) 4,056건 중 1,435건(35.4%)이 뉴욕 장 마감 16:00 뒤에 접수됐어요. 이슈는 이렇게 표현합니다. "So for roughly a third of earnings events, the run reads the result and is then paid for the day the market reacts to it."
그렇다면 이전 성적이 부풀었을까요? 단정할 수 없어요. 이 오류로 성적이 실제로 얼마나 달라졌는지는 이슈도 확인하지 않았고, 본문에서도 "Whether the model reads the direction correctly is a separate question"이라고 선을 긋습니다. 확실한 건 하나예요. 버전이 다르면 채점 기준이 달라서 숫자를 나란히 놓고 비교하기 어렵다는 점입니다. 이미 채점된 결과는 종전 기준이 유지되므로 노트는 "start a new run to compare like with like"라고 권해요.
나머지 두 가지는 작아요. 대화형 CLI를 켤 때 새 버전을 알려 주는 기능은 하루 최대 1회 백그라운드로 확인하고 TRADINGAGENTS_NO_UPDATE_CHECK=1로 끌 수 있어요. 릴리스마다 설치용 패키지 파일(wheel)도 붙습니다.
이전 버전과 한국 종목은 어떻게 되나요?
v0.6.0과 v0.5.2는 무엇을 바꿨나요?
- v0.6.0(2026-10-03): 모델 등급별로 다른 회사 모델을 섞을 수 있어요. 노트의 예시는 "the managers on Claude while the analysts run on OpenAI"입니다. 한 페이지짜리 HTML 보고서도 이때 추가됐어요.
- v0.5.2(2026-09-29): 애널리스트가 동시에 일해서 그 단계가 "about as long as the slowest one"이 됐어요. 보고서 첫머리에는 분석일, 버전, 모델, 데이터 공급원을 기록하고 한국을 포함한 비미국 증시 지수로 채점하게 바뀌었습니다.
한국 종목은 어디까지 되나요?
README는 "TradingAgents works with any market Yahoo Finance covers, using the exchange-suffixed ticker."라고 설명해요. 코스피 종목은 종목코드 뒤에 .KS, 코스닥 종목은 .KQ를 붙이는 형식입니다. default_config.py 기준으로 .KS는 코스피 지수(^KS11), .KQ는 코스닥 지수(^KQ11)를 벤치마크 지수(성적을 비교하는 기준 지수)로 삼아 결정의 초과 성과를 계산해요.
v0.5.2 이전에는 이 표에 한국이 없었어요. 이슈 #1392(2026-09-23 등록)는 대만 종목이 미국 S&P 500 ETF(SPY) 기준으로 채점된다고 지적했고, v0.5.2 노트가 "Benchmarks for Taiwan, Korea, Singapore and the main European exchanges."를 추가했습니다. 그전 버전으로 돌린 한국 종목의 초과 성과는 SPY 대비였던 셈이에요. 수익률은 settlement.py 설명대로 "Returns are compared as percentages, each in its own currency."이니 원화 종목은 원화 기준으로 계산됩니다.
빈칸도 있어요. 확인한 범위에서만 적어 볼게요.
- 재무제표: 미국 SEC 공시 시스템(EDGAR)은 SEC 신고 기업만 다뤄요. README는 그 밖의 상장사가 "falls through to the next vendor in the chain"이라고 적고, 한국 상장사는 야후로 넘어가요. 야후 재무제표는 공개 시점을 알 수 없어 과거 날짜 실행에서는 제공되지 않으니, 과거 날짜로 한국 종목을 돌리면 재무제표 없이 판단하게 될 수 있습니다. README 규칙에서 따져 본 내용이고 직접 실행해 확인하지는 못했어요.
- 뉴스: 거시 뉴스 기본 검색어(default_config.py)에는 연준, S&P 500, ECB, 영란은행, 일본은행이 있고 한국은행과 코스피는 없어요.
- 소셜과 한국어 뉴스: 한국 종목 관련 글이 얼마나 잡히는지는 확인하지 못했습니다.
- 언어: 보고서는 한국어로 받을 수 있어요. 에이전트끼리의 토론은 설정 주석대로 "Internal agent debate stays in English for reasoning quality"입니다.
리서치 보조로 쓰려면 어떻게 하면 되나요?
프로젝트 문서가 스스로 제시하는 쓰임새 안에서 순서를 잡아 볼게요. 수익을 약속하는 사용법은 어느 출처에도 없어요.
- 찬반 논점 체크리스트로 읽기: 강세·약세 리서처와 리스크 토론자 3명의 발언이 보고서에 남아요. 내가 놓친 반대 논거를 확인하는 용도입니다.
- 숫자를 원 데이터와 대조하기: README는 "the market analyst grounds exact price and indicator claims in a verified data snapshot"라고 설명해요. v0.5.2부터 보고서에 모델과 데이터 공급원이 적히니 보고서 숫자를 직접 대조하는 출발점으로 삼을 수 있어요.
- 여러 날짜와 종목으로 묶어 보기: README는 "One run gives one decision, which cannot tell you whether the system decides well."라고 말해요.
tradingagents backtest(과거 날짜로 돌려 보는 모의 실험)로 날짜와 종목 격자를 돌려 등급별 결과를 묶어 보세요. 다만 "Backtest results are not guaranteed to match any published figure."라고 README가 먼저 밝혀요. - 내 보유 현황 넣기:
--portfolio my_book.json에 현금과 보유 수량을 넣으면 트레이더, 리스크, 포트폴리오 매니저가 그 기준으로 써요. 넣지 않으면 보고서는 "written for a reader who applies it to their own position" 형태입니다. - 비용 줄여 실험하기: Shallow 깊이,
--analysts market,news처럼 애널리스트 일부만 선택, 로컬 Ollama 모델, ChatGPT 구독 실행이 공식 옵션이에요. 공식 문서에는 한 번 실행하는 데 드는 비용이나 시간 수치가 없고, 이슈 #750(2026-05-06 등록, 열린 상태)의 사용자 분석은 한 번 실행에 LLM 호출이 16번에서 22번 든다고 제기해요. 공식 측정이 아니고 이후 버전에서 달라졌을 수 있습니다.
이 다섯 단계는 판단을 맡기는 쓰임이 아니라 내가 확인할 거리를 늘리는 쓰임이에요. 매매는 사람이 따로 결정해야 합니다.
논문 성적과 한계는 어디까지 읽어야 하나요?
논문 수치는 범위가 좁아요
TradingAgents 논문(arXiv 2412.20138, 최신 v7은 2025-06-03 제출)의 백테스트는 2024-01-01부터 2024-03-29까지 약 3개월 동안 진행됐고 표 1에는 AAPL, GOOGL, AMZN 3개 종목의 결과만 실렸어요. 당시 모델은 gpt-4o-mini, gpt-4o, o1-preview로 지금 기본 모델과 달라요. 비교 기준 전략은 Buy and Hold(매수 후 보유), MACD, KDJ+RSI, ZMR, SMA 5종이고 종목마다 가장 성과가 좋은 기준 전략이 달라서 차이를 한 숫자로 뭉뚱그리면 안 됩니다.
| 종목 (2024-01-01~2024-03-29 약 3개월, 논문 표 1) | TradingAgents 누적수익률(%) | 그 종목에서 가장 좋았던 기준 전략 | 기준 전략 누적수익률(%) | 차이(%p) |
|---|---|---|---|---|
| AAPL | 26.62 | KDJ&RSI | 2.05 | 24.57 |
| GOOGL | 24.36 | Buy and Hold | 7.78 | 16.58 |
| AMZN | 23.21 | Buy and Hold | 17.1 | 6.11 |
차이 열은 제가 표의 두 수치를 직접 뺀 값이에요. 같은 기간 AAPL을 사서 들고 있는 전략은 누적수익률 -5.23%로 집계됐어요. 연환산 수익률은 약 3개월 결과를 1년으로 환산한 값이라 1년 실적으로 읽으면 틀려요.
논문 스스로도 각주에서 샤프 비율(위험 대비 성과를 보는 지표)이 "The highest Sharpe Ratio exceeds our expected empirical range"라고 인정했어요. 이유는 "We believe the exceptionally high SR resulted from the phenomenon that there were few pullbacks in TradingAgents during that period."라고 설명합니다. 기간 중 하락 구간이 적었다는 말이에요. 결론의 향후 과제도 "Future work will focus on deploying the framework in a live trading environment"여서 논문 시점에는 실거래 검증이 없었습니다. 실험은 "11 LLM calls & 20+ tool calls/prediction" 규모의 호출을 쓴 구성이었어요. Tauric Research 약관도 백테스트와 시뮬레이션 결과가 예시일 뿐이라며 "Past or simulated performance does not guarantee future results."라고 적습니다.
같은 입력도 결과가 달라질 수 있어요
README 설명은 이래요. "TradingAgents is LLM-driven, so two runs of the same ticker and date can differ." 결함이 아니라 언어모델 기반 도구에서 예상되는 동작이라고 봅니다. 날짜를 고정하면 가격과 지표 구간은 고정되지만 뉴스와 소셜 데이터에는 "지금" 시점이 섞여요. README도 "Pin the analysis date to hold the price and indicator window fixed"라고 적은 뒤 그 한계를 덧붙입니다.
모델이 이미 미래를 알 수 있다는 문제도 남아 있어요. 이슈 #805(2026-05-11 등록, 열린 상태)는 과거 날짜로 백테스트해도 그 뒤에 학습한 모델 가중치에 이후 사건 지식이 들어 있을 수 있다고 지적했습니다. 논문 1저자인 저장소 멤버가 2026-06-13(UTC) 댓글에서 데이터 쪽 누설은 고쳤다고 밝히고, 모델 쪽은 "a separate, fundamental limitation a code change can't fully eliminate"라고 답했어요. 릴리스 노트 v0.4.0부터 v0.7.0까지 미래 정보 누설(look-ahead) 수정이 반복해서 담긴 점도 같은 이야기입니다. 버전이 다른 백테스트끼리는 같은 잣대로 비교하지 않는 편이 맞아요.
커뮤니티는 어떻게 보고 있나요?
Hacker News 스레드(2026-09-08 게시, 120 points, 댓글 81개)는 회의론이 우세했어요. 다중 에이전트 구조의 효용을 묻는 목소리가 있었습니다. "Isn't a single agent with a good harness better than any multi agent env?"라는 질문이 대표적이에요. 헤지펀드에서 10년 일했다는 댓글은 "Having worked in hedge funds for the last decade, this seems to miss the mark."라고 평가했고 토큰 비용을 걱정하는 글도 여럿이었어요. 지수 ETF와 견주자는 제안도 나왔는데 "It would be more interesting to compare trading agents with index tracking ETFs."가 그 문장입니다.
이건 반응과 정서이지 사실 근거가 아니에요. 팩트는 앞의 공식 문서로 따로 확인했습니다. Reddit과 X에서는 원문을 확인할 수 있는 토론을 확보하지 못해서 다루지 않았어요.
마무리
TradingAgents는 AI 에이전트들이 역할을 나눠 토론하고 5단계 등급과 근거 보고서를 내는 리서치 보조 도구예요. 주문은 넣지 않고 프로젝트도 투자 조언이 아니라고 밝힙니다. 2026-10-16 v0.7.0은 구독 실행과 채점 시점 수정을 담았고, 논문 수치는 2024년 3개월·3개 종목 실험이라는 범위 안에서만 읽어야 해요.
도구를 쓸지는 천천히 검토하셔도 충분합니다. 궁금한 지점이 생기면 아래 참고 자료에서 원문을 열어 더 알아보세요.
자주 묻는 질문
TradingAgents가 실제로 주식을 사고팔아 주나요?
아니요. 조사 시점(2026-10-26) 기준으로 의존성 19개에 증권사 연동 도구가 없고 소스에서도 주문 제출 코드가 나오지 않았어요. 결과물은 5단계 등급과 근거 보고서이고, 매매는 사람이 따로 해야 합니다. README도 투자 조언이 아니라고 밝혀요.
ChatGPT 구독만 있으면 무료로 돌릴 수 있나요?
무료는 아니에요. 2026-10-16 v0.7.0부터 API 키 대신 ChatGPT Plus·Pro 구독으로 실행할 수 있지만 구독료는 그대로 들고, 실행은 구독 사용량 한도에서 차감돼요. 이 방식에서는 temperature와 max_tokens 설정도 쓸 수 없습니다.
한국 종목도 분석할 수 있나요?
형식상 가능해요. 코스피는 종목코드 뒤에 .KS, 코스닥은 .KQ를 붙이고 v0.5.2(2026-09-29)부터 각각 코스피 지수와 코스닥 지수 대비로 채점해요. 다만 과거 날짜 실행에서는 야후 재무제표가 제공되지 않아 한국 종목의 재무 데이터가 얇을 수 있고, 이 부분은 README 규칙으로 따져 본 것이라 직접 실행해 확인하지는 못했습니다.
논문에 나온 수익률을 기대해도 되나요?
기대의 근거로 삼기는 어려워요. 논문 백테스트는 2024-01-01부터 2024-03-29까지 약 3개월, AAPL·GOOGL·AMZN 3개 종목의 결과이고 README는 "Backtest results are not guaranteed to match any published figure."라고 밝혀요. 논문도 실거래 환경 배치를 향후 과제로 남겼습니다.
한 번 돌리는 데 비용이 얼마나 드나요?
공식 README와 릴리스 노트에는 실행 1회당 비용이나 시간 수치가 없어요. 이슈 #750(2026-05-06 등록)의 사용자 분석은 한 번 실행에 LLM 호출이 16번에서 22번이라고 주장했지만 공식 측정이 아니고 이후 버전에서 달라졌을 수 있어요. Shallow 깊이와 애널리스트 일부만 선택하는 방식으로 호출을 줄여 볼 수 있습니다.
참고 자료
- TradingAgents README (main)
- TradingAgents v0.7.0 릴리스 노트 (2026-10-16)
- TradingAgents v0.6.0 릴리스 노트 (2026-10-03)
- TradingAgents v0.5.2 릴리스 노트 (2026-09-29)
- portfolio.py: 보유 종목 입력, 주문 경로 없음 명시
- default_config.py: 기본 모델, 토론 라운드, 벤치마크 지수 표
- TradingAgents 논문 arXiv 2412.20138
- OpenAI: Sign in with ChatGPT, ChatGPT plan usage for open-source apps
- Tauric Research Terms of Service
- Issue #1518: 결정일 장 마감 뒤 뉴스 선반영 문제
- Issue #1392: 비미국 종목이 SPY 기준으로 채점되던 문제
- Issue #805: 모델 가중치 속 미래 지식 누설 문제 제기
- Issue #750: 실행당 LLM 호출 수와 캐시 적중 제기
- Hacker News: Multi-Agents LLM Financial Trading Framework (2026-09-08)