벡터 없는 RAG가 정말 다 이겼을까요? PageIndex 목차 트리 색인 제대로 뜯어보기 (2026 기준)
 퀀텀점프클럽 정상록8 min read4 views
Free Resource
PDF · Free
목차만 보고 답 찾는 AI 검색법, 과장 빼고 보기: 비개발자를 위한 쉬운 가이드
Get the practical guide first, before diving into the full article.
벡터 없는 RAG가 정말 다 이겼을까요? PageIndex 목차 트리 색인 제대로 뜯어보기 (2026 기준)
왜 이 트윗 하나가 이렇게까지 커졌을까요
바이럴 트윗의 핵심 숫자 98.7%는 다른 제품 이야기였고, "청킹이 없다"는 설명도 절반만 맞았습니다. 2026-09-28, X(트위터) 계정 @oliviscusAI가 올린 트윗 하나가 좋아요 4,867개, 답글 179개를 모으며 커뮤니티를 흔들었습니다. 첫 문장부터 "The entire RAG industry is about to get cooked"(RAG 산업 전체가 끝장날 것이다)로 시작해, 벡터 DB도 임베딩도 청킹도 유사도 검색도 없고 FinanceBench 98.7%로 모든 벡터 RAG를 이겼으며 무료 오픈소스라는 설명이 이어졌습니다.
이 글을 읽는 분 중에도 "그래서 우리 회사 문서 검색, 이거 하나면 되는 건가요?"라는 생각이 스쳤을 것 같아요. 산업 전체가 끝난다는 말까지 나왔으니 당연한 궁금증이죠. 그래서 오늘은 트윗이 말한 내용을 공식 저장소·벤치마크 원문과 하나씩 맞춰보고, 실제로 어떤 문서에 쓸 만한지까지 정리해봤습니다.
PageIndex, 벡터 대신 뭘 쓰길래 이런 얘기가 나올까요
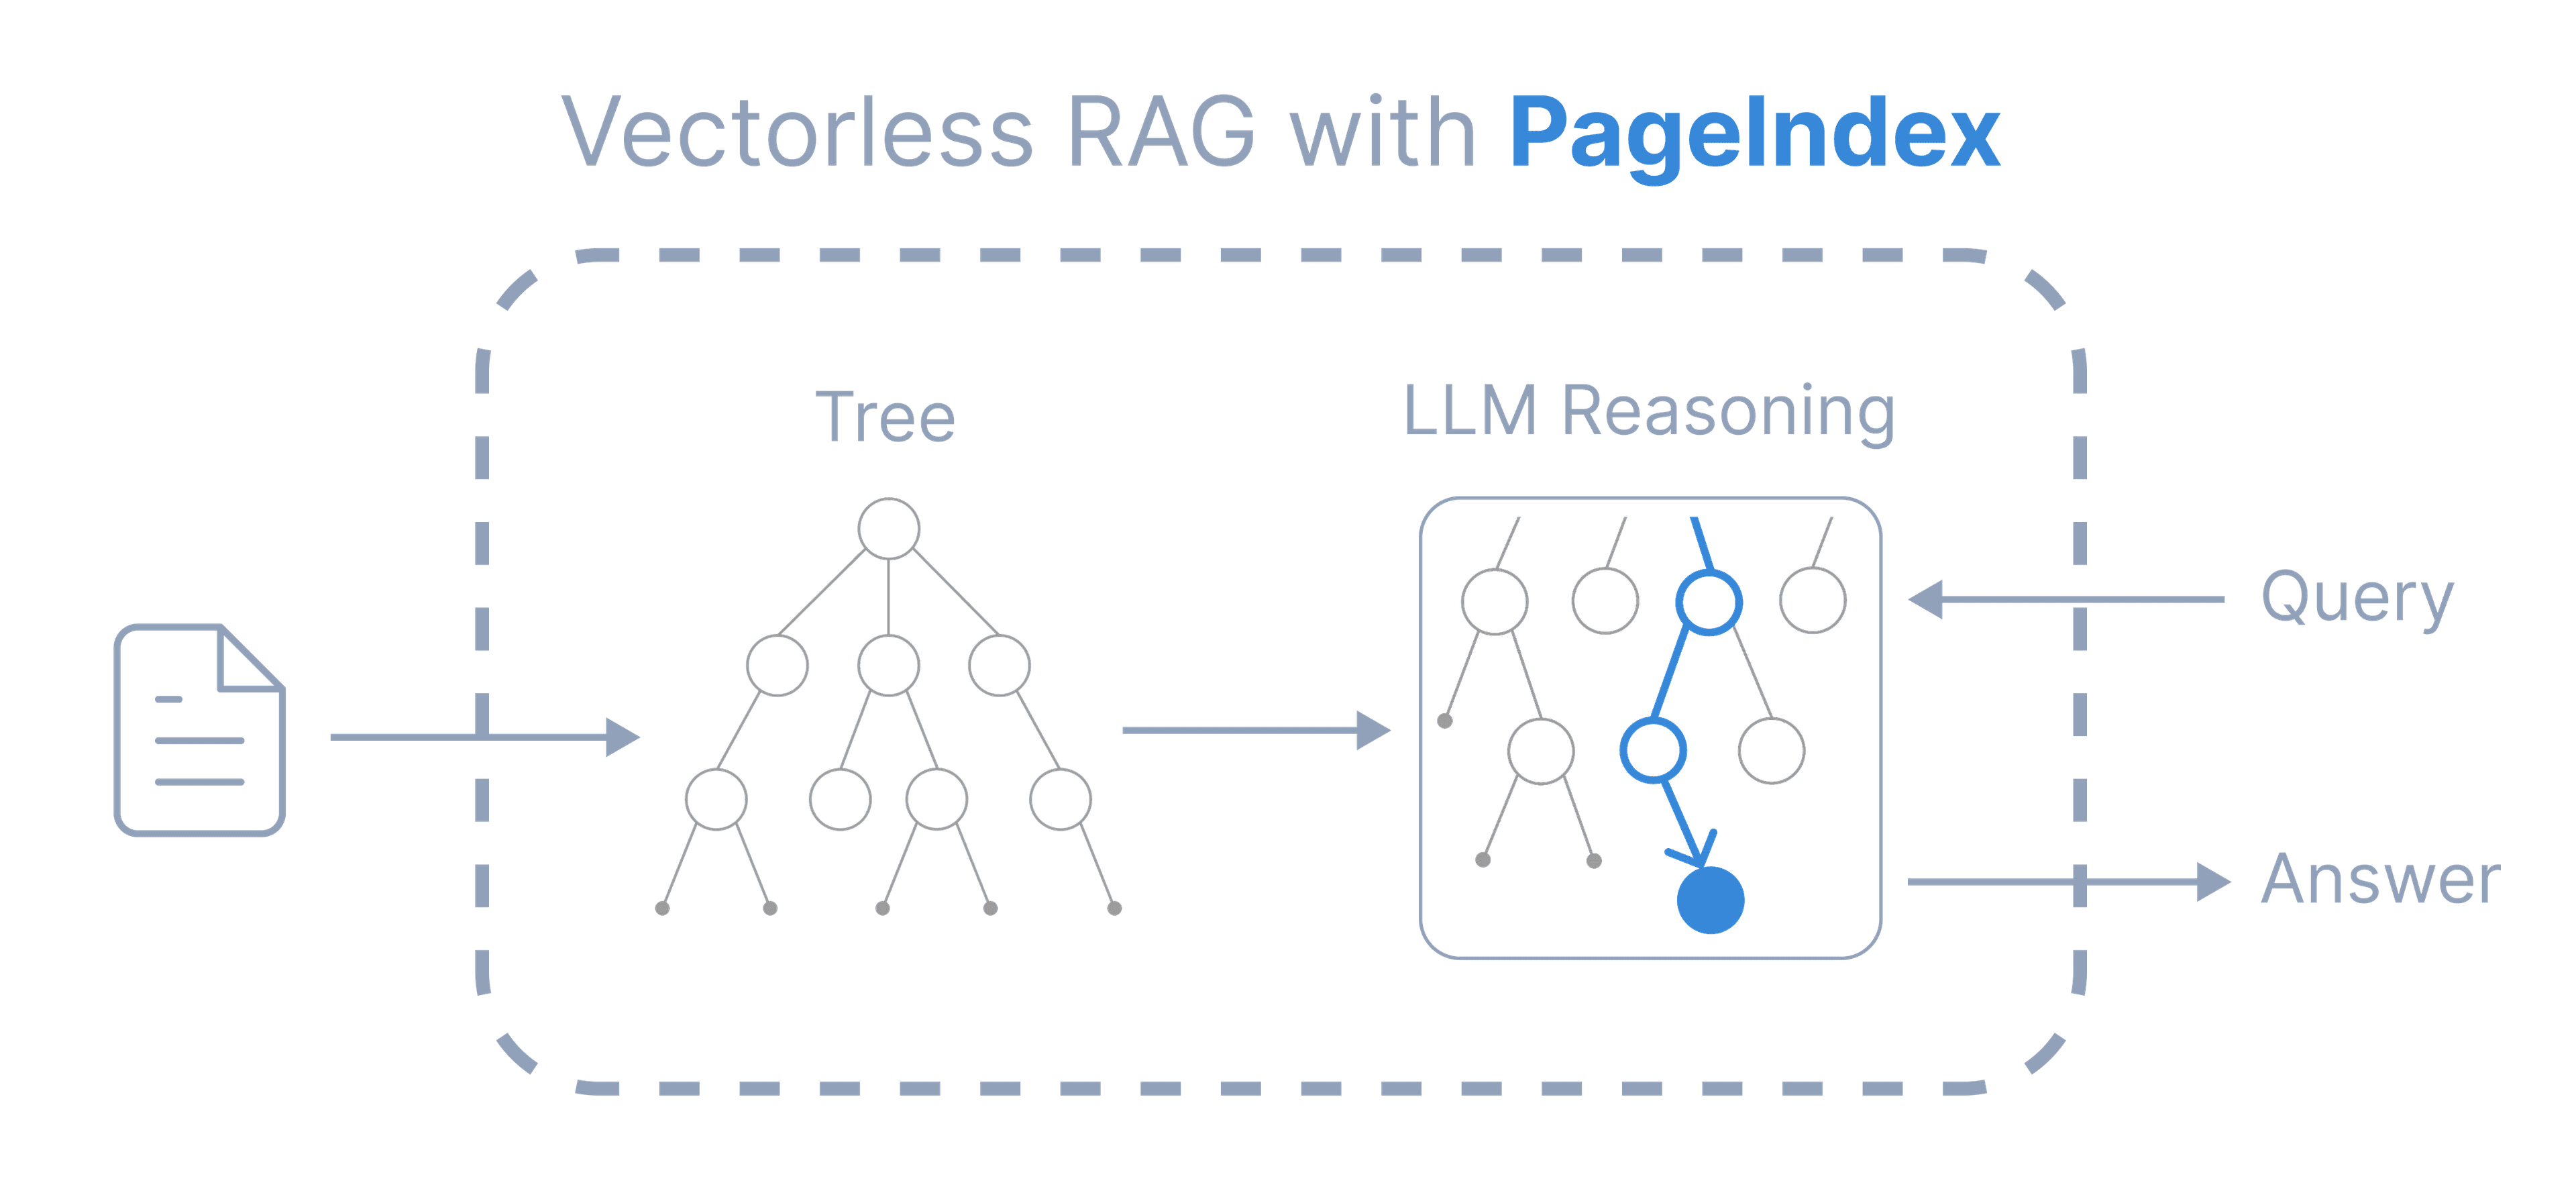
PageIndex가 하는 일은 사실 단순해요. 문서를 숫자 벡터로 바꾸는 대신, 제목·쪽 범위·요약이 달린 계층형 목차 트리로 바꿉니다. 질문이 들어오면 LLM이 이 트리를 책 목차 펼치듯 위에서부터 읽으면서, 노드마다 "이 하위 절을 열어볼 가치가 있는가"를 판단해 내려갑니다. 영어로는 vectorless RAG(벡터 없는 RAG), 작동 구조 그대로 부르면 목차 트리 색인이라고 할 수 있습니다.
PageIndex, 벡터 대신 뭘 쓰길래 이런 얘기가 나올까요
이미지 출처: github.com
PageIndex File System 공식 블로그(2026-05-03)는 이 판단 과정을 이렇게 설명합니다.
"the LLM ... makes a yes/no judgment at every node (is this subtree worth opening for this query?)" (LLM이 노드마다 "이 하위 트리를 이 질문에 열어볼 가치가 있는가"를 예/아니오로 판단합니다.)
기존 벡터 RAG와 PageIndex를 단계별로 나누면 이렇습니다.
| 단계 | 벡터 RAG (5단계) | PageIndex (2단계) |
|---|---|---|
| 1 | 문서를 고정 길이로 자른다(예: 512토큰) | 문서 제목 구조대로 트리를 만든다 |
| 2 | 조각마다 임베딩 모델로 벡터를 만든다 | LLM이 트리를 읽으며 열 절을 판단한다 |
| 3 | 벡터 DB(Chroma·Pinecone·pgvector 등)에 저장한다 | (없음) |
| 4 | 질문도 벡터로 바꿔 유사도 상위 K개를 꺼낸다 | (없음) |
| 5 | 꺼낸 조각을 LLM에 넣어 답을 만든다 | (없음) |
저장소는 2026-10-01 17:38 KST 기준(GitHub API 실측) 스타 38,274개, 포크 3,320개를 기록하고 있어요. MIT 라이선스 Python 패키지라 pip install -U pageindex 한 줄이면 설치됩니다. Python 3.10 이상에서 동작하고, 최신 버전은 2026-09-28에 나온 v0.2.20입니다. 다만 pyproject.toml에는 개발 단계가 아직 Development Status :: 3 - Alpha로 표시돼 있습니다.
트윗은 뭐라고 했고, 저장소는 뭐라고 했을까요
트윗은 "FinanceBench 98.7%로 모든 벡터 RAG를 이겼다", "청킹이 없다"를 핵심 근거로 내세웠습니다. 비용 비교(2.1~16.6배 저렴)는 트윗이 아니라 공식 저장소 README에 나온 수치입니다. 출처를 구분해 세 가지를 하나씩 공식 자료와 맞춰볼게요.
98.7%의 진짜 주어는 누구인가요
이 98.7%는 오픈소스 PageIndex가 아니라, PageIndex 위에 VectifyAI가 만든 상용 시스템 Mafin 2.5의 자체 보고 수치입니다. 데이터는 FinanceBench 공개 150문항이고 모호하거나 복수 정답인 문항은 사내 전문가가 재판정했습니다.
Mafin 2.5 저장소의 벤치 자료 자체도 범위를 분명히 적어뒀어요.
"The current benchmark primarily focuses on simple retrieval tasks based on a single document" (현재 벤치마크는 주로 단일 문서 기반의 단순 검색 과제에 초점을 맞추고 있습니다.)
오픈소스 로컬 모드의 공식 수치는 따로 있습니다. 2026-08-17 공개된 PageIndex-OSS-Benchmark는 34개 PDF·1,945쪽·62문항으로 측정했는데, 표·차트·그림·계산 문항은 빼고 답이 본문 서술 문장에 있는 문항만 남겼습니다. 결과는 모델과 추론 강도에 따라 85.5%(gpt-5.6-luna, 추론 없음)부터 100.0%(gpt-5.6-terra·gpt-5.6-sol, 추론 high)까지였고요. 이 벤치에는 벡터 RAG 비교군이 없습니다. 색인을 거부한 문서도 실패로 세지 않고 제외했다는 점도 짚어야 합니다.
"documents it refuses are excluded rather than scored as failures" (색인을 거부한 문서는 실패로 채점하지 않고 제외합니다.)
README의 FinanceBench 비교 그림에는 "PageIndex 98.7%, 벡터 RAG 50%"라는 표기가 있는데, 이 50%를 어떤 설정과 모델로 측정했는지는 README와 Mafin 저장소 어디에도 출처가 없습니다. 기준이 불명확한 숫자와 상대 비교를 하는 건 의미가 없어서, 이 글에서는 "벡터 RAG 대비 몇 배 우월" 같은 표현을 쓰지 않았습니다.
청킹이 정말 하나도 없나요
절반만 맞는 이야기예요. 512토큰처럼 의미를 무시하고 기계적으로 자르는 고정 길이 분할은 정말 없습니다. 다만 config.yaml 기본값으로 한 노드가 10쪽을 초과하면서 20,000토큰 이상이면, 하위 구조를 다시 찾아 쪼개는 로직이 들어 있어요. 정확히 말하면 "분할 자체가 없다"가 아니라 "문서 구조를 무시한 기계적 분할이 없다"가 맞는 설명입니다.
트리를 만드는 방식도 함께 봐야 해요. 2026-08-26 공개된 PageIndex Flash는 PDF의 글자 크기·굵기·번호 매김 같은 레이아웃 통계만으로 제목을 찾습니다.
"Builds the PageIndex tree structure from a PDF using layout statistics without an LLM" (레이아웃 통계만으로 PDF에서 PageIndex 트리 구조를 만들며, 이 단계에는 LLM을 쓰지 않습니다.)
구버전 경로는 목차 탐지부터 쪽 번호 매칭까지 전부 LLM에 맡겼는데 2026-08-26 이후로는 Flash가 기본값이 되면서, 트리 뼈대를 만드는 데 드는 LLM 호출이 크게 줄었습니다.
비용 2.1~16.6배 절감, 무엇과 비교한 걸까요
공식 저장소 README에는 "PageIndex가 52쪽 문서에서 2.1배, 420쪽 문서에서 16.6배 저렴하다"는 표가 있습니다. 이 수치의 기준선은 벡터 RAG가 아니라 "PDF 전체를 모델에 통째로 넣는 방식"이에요. 같은 질문에 PDF 전체를 gpt-5.6-sol에 직접 넣었을 때와 PageIndex로 검색했을 때를 비교한 값이고(프롬프트 캐싱은 끄고, 두 방식이 같은 답을 낸 문서만 포함), 85쪽 문서에서는 3.4배, 198쪽 문서에서는 7.8배 차이가 났습니다(805쪽 문서는 컨텍스트 창을 넘어서 비교 자체가 안 됐습니다). 벡터 RAG와 직접 비교한 공개 수치는 확인되지 않았습니다.
비용은 색인 비용과 검색 비용으로 나뉜다는 점도 챙겨야 해요. 벡터 RAG는 색인할 때 임베딩 비용을 한 번 쓰고 검색은 거의 공짜지만 PageIndex는 질문마다 LLM이 트리를 탐색하는 비용이 따로 붙습니다. 로컬 모드 색인 비용은 벤더 측정으로 쪽당 약 $0.001이라, 1,000쪽짜리 교과서를 색인해도 1달러 남짓입니다. 질문당 비용은 $0.0031(gpt-5.6-luna, 추론 없음)부터 $0.0819(gpt-5.6-sol, 추론 high)까지, 모델 선택에 따라 약 26배까지 벌어집니다. 지연 속도는 공식 수치가 없는데, 공동 개발자가 2025-08-29 Hacker News 댓글에서 "트리가 크면 정확도를 우선하므로 벡터 방식보다 느릴 수 있다. 속도가 우선이면 벡터 DB를 쓰라"고 직접 답했습니다.
클라우드 버전은 가격 체계가 따로 있어요. 색인은 쪽당 $0.01(1회), 활성 페이지 보관은 쪽당 월 $0.001(매월 첫 1,000쪽 무료)이고 검색 자체에는 추가 요금이 없습니다. LLM 비용은 사용자가 모델 제공자에게 직접 내야 해요. 무료 크레딧 $10도 받을 수 있습니다.
한국 공공·기업 문서에도 쓸 수 있을까요
공식 문서 어디에도 한국어 지원 여부가 명시돼 있지 않습니다. 소스코드를 열어보면 한글 키워드가 사전 전체에서 69개 들어 있어요. 참고문헌 표기 변형(OCR 오인식 포함) 55개, 초록·요약 7개, 목차·장·부록·표·그림·소개·제목 같은 단어 7개로 나뉩니다. 다만 언어별 비교가 가능한 section_keywords에서는 전체 7,613개 중 한글 항목이 0개입니다. 테스트 픽스처에도 아랍어·힌디어·일본어·중국어 PDF는 있지만 한국어 PDF는 없었습니다.
직접 소규모로 테스트해봤습니다. 2026-10-01에 자체 제작한 PDF 4건으로 해본 실험이라 합성 문서라는 한계가 있고, 경향 확인용으로만 참고해 주세요. 북마크 없는 한국어 계약서는 "제N장" 단위 계층이 통째로 빠졌어요. 같은 계약서에 PDF 북마크를 넣었더니 장-조 계층은 복원됐지만, 일부 조항이 다른 조항 아래 중복 배치되는 이상한 노드가 생겼습니다.
실무 체크리스트는 이렇게 정리됩니다.
- HWP·HWPX는 그대로 못 넣습니다. 로컬 모드는 PDF만 받습니다. 코드(
local_api.py)에도 "only PDF files are supported in local mode"(로컬 모드에서는 PDF 파일만 지원됩니다)라고 명시돼 있어요. 한글에서 PDF로 내보낼 때 책갈피(개요) 포함 옵션을 켜두면 Flash가 내장 목차를 우선 씁니다. - 스캔본·날인 계약서는 로컬에 OCR이 없어서, 텍스트가 비면
toc_source가unreadable로 찍힙니다. 미리 OCR로 텍스트 레이어를 입히거나 클라우드를 쓰는 편이 안전합니다. - 색인 직후 트리 JSON을 사람이 한 번 봐야 해요. 대제목이 빠지면 LLM이 엉뚱한 가지를 탐색하거든요.
- 노드 크기 기본값(10쪽·20,000토큰)은 영어 기준으로 잡힌 값입니다. 한국어 문서는 같은 분량에서 토큰 수가 달라질 수 있어, 실제 문서로 한 번 확인해보는 게 안전해요.
- 로컬 모드라고 문서가 내 컴퓨터 밖으로 전혀 안 나가는 건 아닙니다. 색인된 문서와 트리는 디스크에 남지만 탐색 과정에서 노드 본문은 지정한 LLM 제공자(OpenAI 등)로 전송됩니다. 사내 보안 문서라면 이 지점부터 확인하시는 게 맞아요.
그래서 어떤 문서에 쓰면 되나요
| 맞는 경우 | 안 맞는 경우 |
|---|---|
| 목차가 뚜렷한 장문 단일 문서(재무보고서, 규정집, 매뉴얼, 계약서) | 짧고 서로 무관한 문서 수천~수만 건(FAQ, 고객지원 KB) |
| "별표 3 참조" 같은 문서 내 상호참조를 따라가야 하는 질문 | 1초 미만 응답이 필요한 챗봇 |
| 쪽 단위 인용·탐색 경로 감사가 필요한 업무 | 자주 바뀌는 문서(증분 갱신 미지원) |
| 질문당 비용보다 정확도가 중요한 고가치 질의 | 스캔본 위주인데 로컬만 써야 하는 환경 |
현실적인 조합은 둘을 섞는 쪽이에요. 수많은 문서 중 "어느 문서를 볼 것인가"는 메타데이터 필터·BM25·벡터 검색으로 먼저 좁히고, 고른 소수의 장문 문서 "안에서"는 PageIndex 트리 탐색을 쓰는 하이브리드가 현실적입니다. 벤더 측 개발자도 2025-08-29 Hacker News 답글에서 비슷한 방식, SQL 메타데이터 검색이나 시맨틱 검색으로 후보 문서를 먼저 좁히는 방식을 제안한 바 있어요.
개발 단계는 아직 Alpha입니다. 2026-08-19부터 2026-09-28까지 40일 사이 정식 릴리스가 11개 나올 만큼 변화가 빠르고, 문서 일부만 바뀌어도 트리를 통째로 다시 만들어야 하는 증분 갱신 미지원 이슈(#316, 2026-06-04 등록)도 열려 있습니다. 대형·복잡 PDF에서 앞쪽 페이지가 누락되는 이슈(#518, 2026-09-18 등록)도 아직 해결되지 않았고요. 핵심 시스템에 바로 넣기보다는, 중요도가 낮은 문서군부터 먼저 시험해보시길 권합니다.
마무리
벡터 없는 RAG라는 이름대로 벡터 DB·임베딩·유사도 검색을 안 쓴다는 설명 자체는 사실이에요. 다만 "모든 벡터 RAG를 이겼다"는 기준선이 불명확한 주장이고, 98.7%는 오픈소스가 아니라 상용 제품 이야기이며, 청킹은 완전히 없는 게 아니라 기계적 분할만 없는 겁니다. 과장을 걷어내고 나면 목차가 뚜렷한 장문 단일 문서를 다루는 검색 엔진으로는 써볼 만한 도구로 남습니다.
PageIndex를 지금 바로 도입할지는, 여러분이 다루는 문서가 "목차가 뚜렷한 장문 단일 문서"에 해당하는지부터 따져보면 답이 나와요. 판단에 필요한 기준은 위에 정리해 뒀습니다.
자주 묻는 질문
검색할 때마다 LLM을 부르면 느리고 비싸지 않나요?
공식 지연 수치는 공개돼 있지 않습니다. 다만 구조적으로 질문마다 LLM이 트리를 순차로 여러 번 호출하기 때문에, 밀리초 단위인 벡터 검색보다 느릴 수 있어요. 공동 개발자도 2025-08-29 Hacker News에서 "트리가 크면 벡터 방식보다 느릴 수 있다. 속도가 우선이면 벡터 DB를 쓰라"고 답했습니다. 질문당 비용은 모델에 따라 $0.0031~$0.0819로, 선택에 따라 약 26배 차이가 납니다.
청킹이 아예 없다는 게 진짜인가요?
512토큰처럼 의미 없이 기계적으로 자르는 고정 길이 분할은 없습니다. 하지만 한 노드가 10쪽을 넘으면서 20,000토큰 이상이면 구조 기반으로 다시 쪼개는 로직이 config.yaml 기본값으로 들어 있어요. 그래서 "분할 자체가 없다"보다 "기계적 분할만 없다"가 정확한 설명입니다.
한국어 문서도 바로 쓸 수 있나요?
공식 문서에는 한국어 지원 여부가 명시돼 있지 않습니다. 자체 소규모 테스트(합성 PDF 4건)에서는 북마크 없는 한국어 계약서의 "제N장" 계층이 전부 빠졌고, PDF 북마크를 추가하자 복원됐어요. HWP는 그대로 못 넣고, PDF로 변환한 뒤 트리 JSON을 사람이 한 번 확인하는 절차가 필요합니다.