DeepSeek Super-agent, Claude Code 견제용이 맞을까요? 보도와 실제 공개 범위 확인
 퀀텀점프클럽 정상록17분 읽기2 views
무료 자료
PDF · 무료
AI 비서 여럿을 두면 왜 더 바빠질까요?
긴 글을 다 읽기 전에, 실무 가이드부터 먼저 챙겨가세요.
DeepSeek Super-agent, Claude Code 견제용이 맞을까요? 보도와 실제 공개 범위 확인
DeepSeek Super-agent는 연구용 프로토타입이고, Claude Code 견제라는 말은 Bloomberg의 프레이밍입니다. 공개 수치는 합성 부하 시험값이라 조건을 붙여 읽어야 해요.
한 줄 답: DeepSeek은 참고용 연구 프로토타입을 공개했고, Claude Code를 겨냥했다는 해석은 Bloomberg 보도에서 나왔어요. 가져갈 것은 제품이 아니라 설계 원칙이고, 공개 수치는 DeepSeek Harness 팀의 합성 부하 시험값이라 다른 도구와의 비교로 읽으면 곤란합니다.
DeepSeek Super-agent는 정말 Claude Code를 겨냥한 걸까요?
결론부터 말하면 Claude Code 견제라는 틀은 Bloomberg가 붙인 것이고, DeepSeek 문서에는 그런 문장이 없어요. 이 글의 DeepSeek Super-agent는 DeepSeek Harness 팀이 2026-10-31에 설계 글과 함께 GitHub에 올린 참고용 프로토타입입니다.
이런 질문이 먼저 떠오를 거예요. "이거 Claude Code 대신 쓸 수 있는 건가?" "15.7분 대 29.5분이면 그만큼 빠르다는 뜻 아닌가?" 보도 제목만 훑으면 그렇게 읽히는 게 자연스러워요.
Bloomberg 기자 Debby Wu는 2026-11-01 기사에서 "DeepSeek has released a prototype of a more autonomous coding agent as it seeks to challenge Anthropic PBC's popular Claude Code."라고 썼어요. TNW와 BW Businessworld는 이 프레이밍을 Bloomberg 인용으로 옮겼습니다. 반면 DeepSeek은 README에서 "Research prototype for reference only, not an official DeepSeek product."라고 선을 그었어요. 같은 문서에는 "Treat it as research code, not production-ready software."라는 당부도 있습니다.
README는 공개판이 내부판이나 설계 글의 구현과 같지 않다고도 밝혔어요. 글에 나온 일부 설계는 앞으로의 방향이라 이 프로토타입에 구현되지 않았다는 설명입니다. 보도 제목, 설계 글, 공개 코드를 한 덩어리로 읽으면 안 되는 이유예요.
이 글은 보도 프레이밍과 DeepSeek의 자기 규정을 나눈 뒤 3~5개 세션 관찰, Router·Worker 구조, 공개판이 하는 일, 수치의 조건, 보안 한계 순서로 짚습니다. 마지막에는 우리 팀에 가져갈 에이전트 설계 원칙 5가지를 정리해요.
한 사람이 동시에 따라가는 세션은 정말 3~5개일까요?
DeepSeek Harness 팀은 설계 글 첫머리에서 문제를 이렇게 정의했어요. 사용자가 일을 여러 개 병렬로 돌리면 세션마다 맥락을 손으로 바꿔 가며 기억해야 하는데, 팀이 관찰한 바로는 한 사람이 보통 동시에 따라가는 활성 세션이 3~5개라는 겁니다. 그래서 단일 작업의 상한은 모델 능력이 정하고, 여러 작업의 상한은 사람의 주의력이 정한다는 게 원문의 논지예요.
주의할 점이 하나 있습니다. 이 3~5개는 실험이나 조사 결과가 아니라 팀의 관찰 진술이에요. 원문에는 표본 수도 조사 설계도 없습니다. "연구로 입증된 한계"처럼 옮기면 원문보다 강한 주장이 돼요. 단위도 대화가 아니라 활성 세션입니다. 서울경제 영문판은 이를 conversations로 옮겼지만 원문 표현은 세션이에요.
팀이 여기서 끌어낸 결론은 단순해요. 세션은 시스템의 구현 세부여야지 사용자의 인지 부담이 되면 안 된다는 것. 에이전트 창을 여러 개 띄워 놓고 어느 창에 무슨 일을 시켰는지 헷갈려 본 분이라면 이 문제의식이 낯설지 않을 겁니다.
Router와 Worker 2개 층은 어떻게 일을 나누나요?
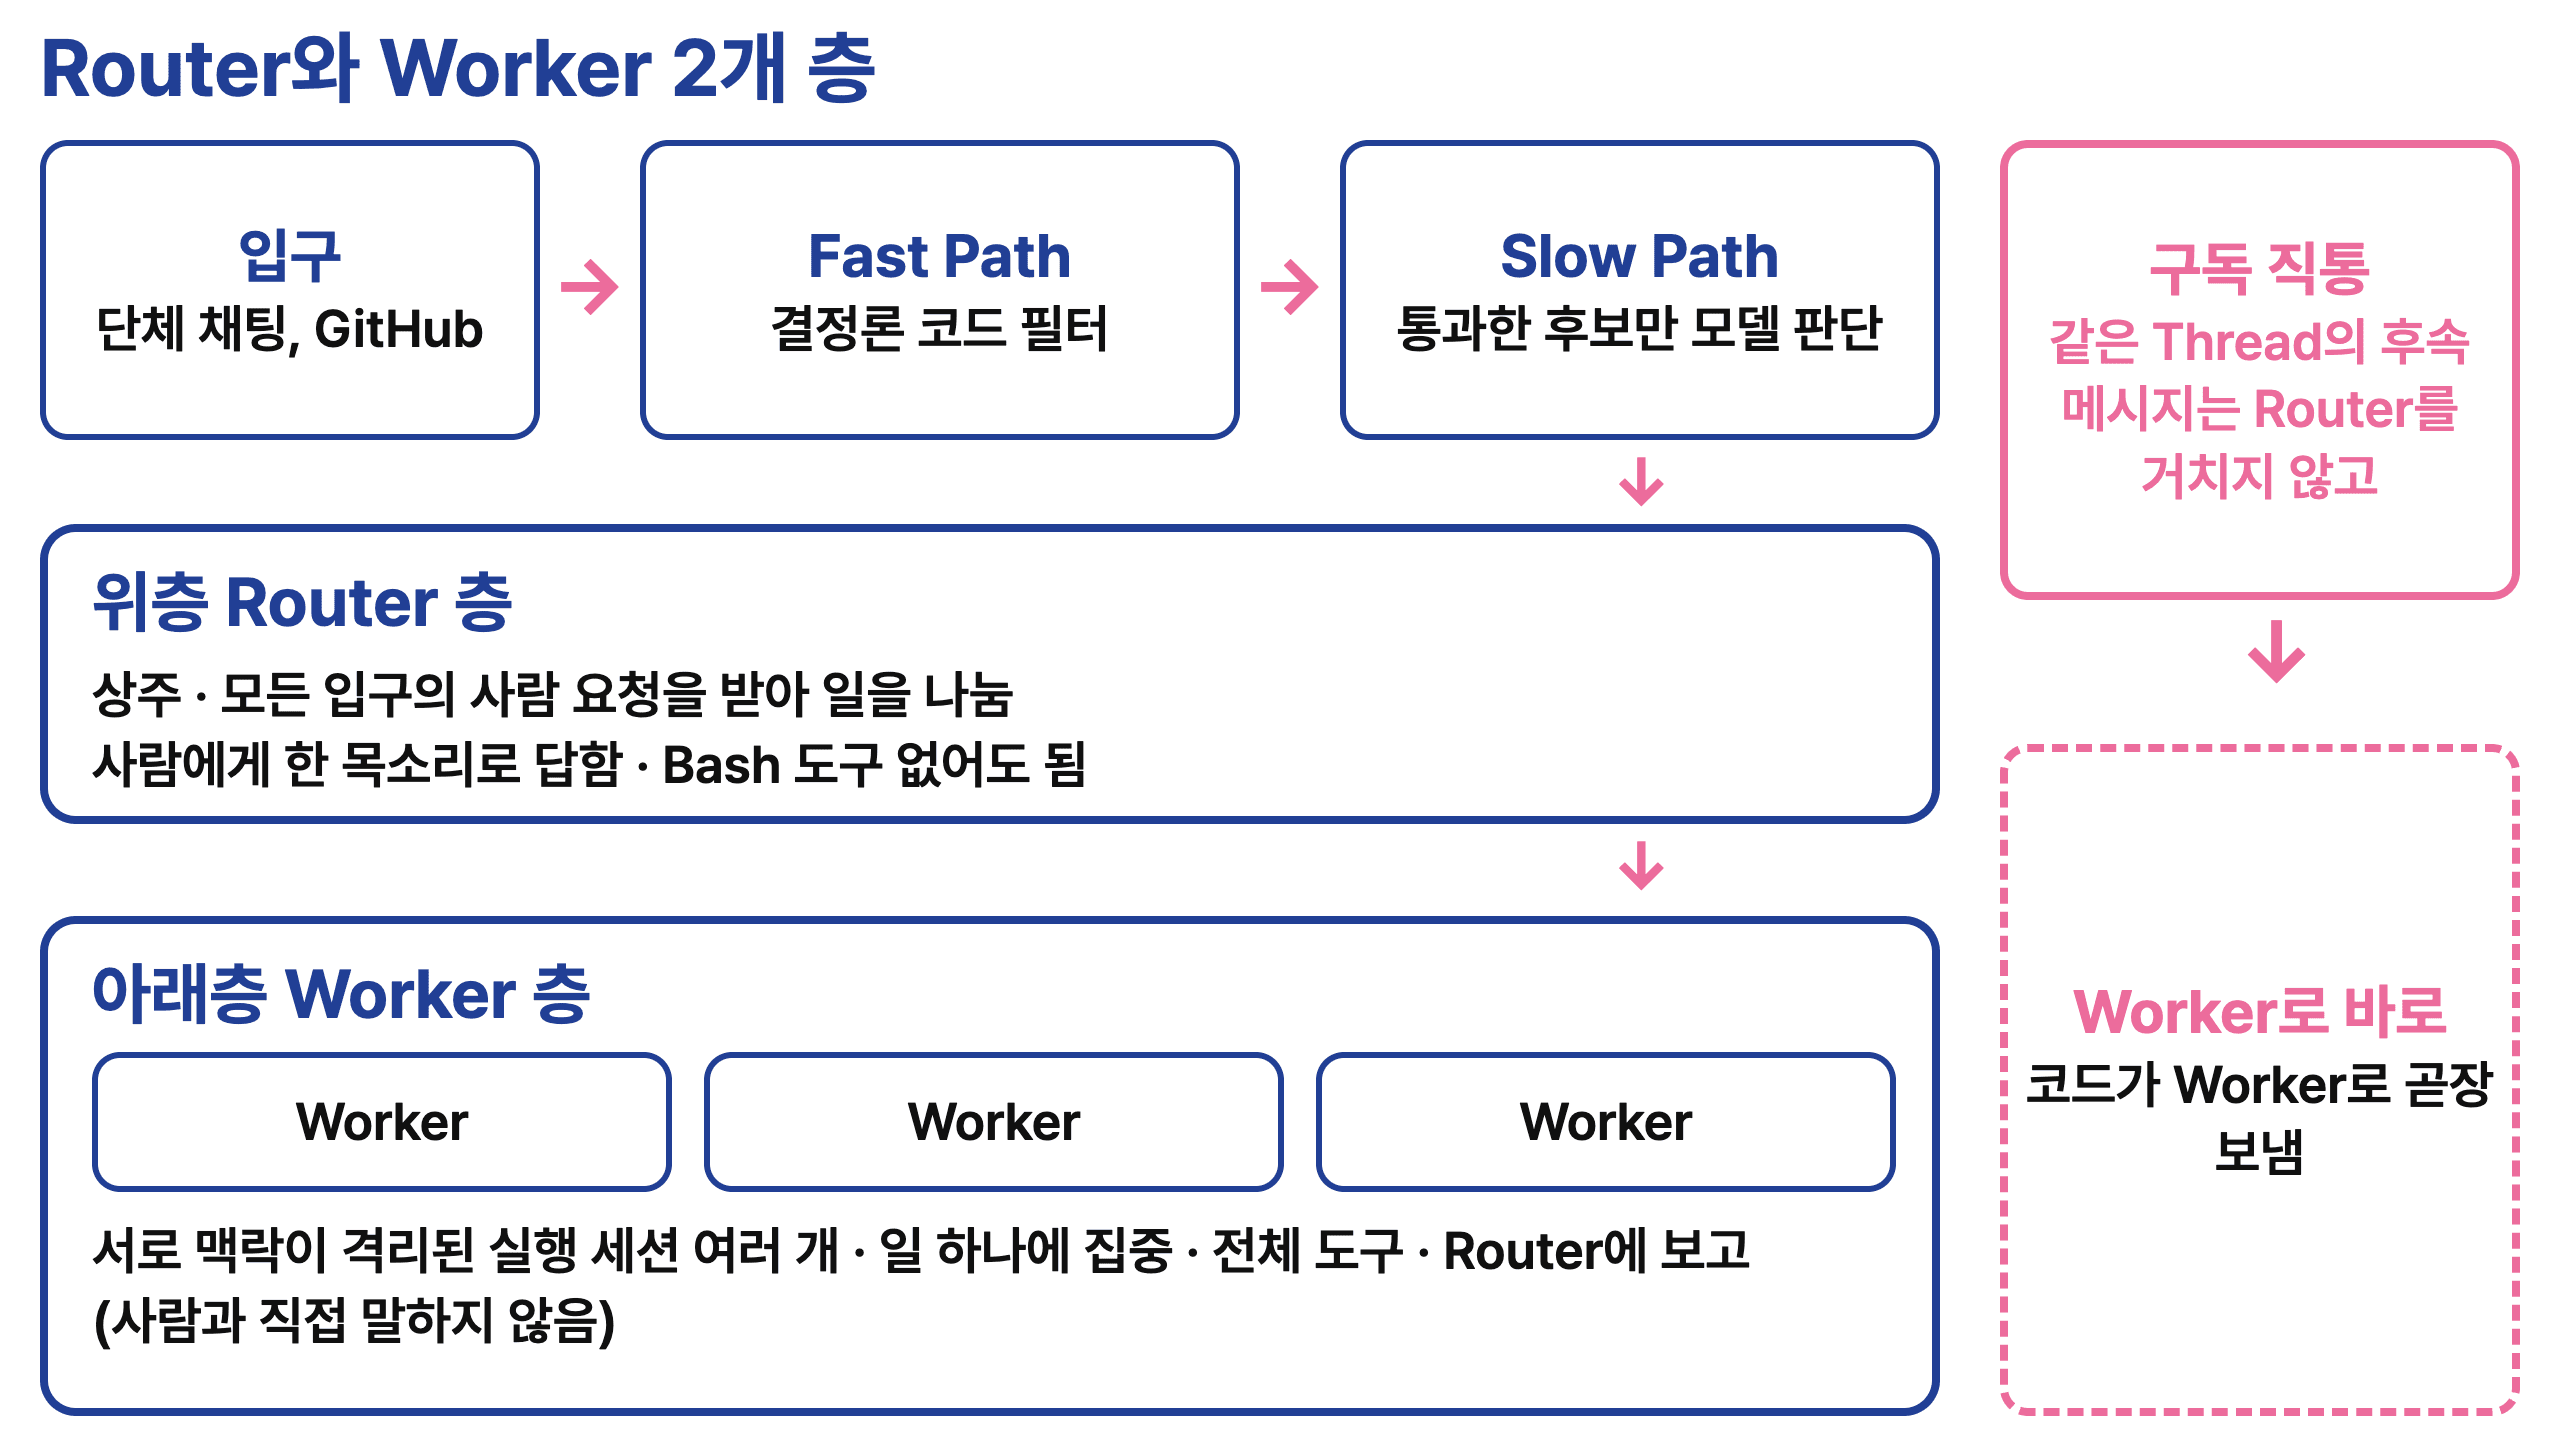
쉬운 비유로 시작할게요. Router는 접수 창구이고, Worker는 각자 자기 일 하나만 붙든 담당자입니다. 담당자는 손님과 직접 말하지 않고, 창구가 한 목소리로 답해요.
Router와 Worker 2개 층은 어떻게 일을 나누나요?
Router가 나누고 Worker가 일 하나씩 맡는다
자료: mp.weixin.qq.com · QJC 재구성
DeepSeek Harness 팀의 설계 글은 세션을 2개 층으로 나눕니다.
- Router 층은 상주하는 전역 라우팅 층이에요. 단체 채팅이나 GitHub 같은 모든 입구에서 사람의 요청을 받아 일을 나눠 줍니다. 설계상 직접 작업을 실행하지 않아서 Bash 도구가 없어도 되고, 원문은 가벼운 모델로도 충분하다고 썼어요.
- Worker 층은 서로 맥락이 격리된 실행 세션입니다. 전체 도구를 달고 일 하나에 집중하며, 원문은 보통 가장 강한 모델을 쓴다고 적었어요. 사람과는 말하지 않고 Router에 보고합니다.
들어오는 이벤트는 2단 필터를 거쳐요. 출처, 그룹, 허용 목록처럼 규칙으로 판단할 수 있는 것은 결정론 코드가 먼저 걸러내고(Fast Path), 통과한 후보만 모델이 판단합니다(Slow Path). Worker가 어떤 Thread를 구독하면 같은 Thread의 후속 메시지는 Router를 거치지 않고 코드가 Worker로 바로 보내요. 이 기능을 팀은 구독 직통이라고 불러요.
팀은 Agent Team과의 차이도 설명했어요. Agent Team은 복잡한 작업 하나를 안에서 쪼개고 Team Lead가 무거운 추론을 지는 방식이고, Router는 작업 사이의 관계와 분배만 다룹니다. 확장에 대해서는 현재 팀 규모에서 단일 상주 Router 세션 1개로 충분하다고 했어요. 규모가 커지면 다층 필터나 샤딩이 필요하고 연속성과 처리량 사이의 트레이드오프가 생긴다고 덧붙였습니다.
설계 글의 결어도 눈여겨볼 만해요. 새 이론을 낸 게 아니라 컴퓨터 시스템의 고전 공학 사상을 에이전트 시스템에 적용했다는 설명입니다. 멀티 에이전트라는 말이 요란하게 들려도 뼈대는 접수와 분배, 필터와 캐시 같은 익숙한 발상이에요.
공개된 프로토타입은 실제로 무엇을 하고, 쓰려면 무엇이 필요한가요?
저장소부터 볼게요. dsh-superagent-prototype은 2026-10-31에 만들어졌고 MIT 라이선스입니다. 2026-11-02 17:41 KST 조회 기준 별은 10,347개이고, 커밋은 1개, 릴리스는 0건, package.json 버전은 0.1.0이에요. 바탕이 된 deepseek-harness 저장소는 2026-08-13에 만들어졌고 같은 시각 별이 268,858개입니다.
README는 이 프로토타입을 이렇게 소개해요. "dsh-superagent is a proactive coding agent for one GitHub repository, packaged as a bundle for DeepSeek Harness. It listens to GitHub and, optionally, Feishu." Feishu는 바이트댄스의 업무용 메신저예요. 흐름은 이렇습니다. 허용 목록에 있는 사람이 요청하면 Ticket(허가된 작업 단위)이 열리고, Worker 세션이 전용 디렉터리(보통 git worktree)에서 일한 뒤, 결과(예를 들면 Pull Request)를 원래 대화에 돌려줘요.
기본값은 observe입니다
수락 모드는 3개예요. off는 요청받지 않은 일을 후보로 만들지 않고, observe는 요청받지 않은 일을 했을 것이라고 기록만 하며, auto는 그 판단을 실제로 수락합니다. 기본값은 observe예요. 직접 요청(멘션, DM)은 어느 모드에서도 동작합니다. 002 Authorization 문서의 권고는 이렇습니다. "Start in observe and switch to auto after reviewing the recorded Decisions."
Worker는 셸 명령을 5초 뒤 백그라운드로 넘겨서, 긴 명령이 끝나길 기다리는 동안에도 새 메시지를 받아요. 관리 패널은 사람이 처리할 것만 먼저 보여 줍니다.
실행 요구사항과 모델 공급자
SETUP.md 기준으로 Node.js 22.19+ 또는 24+, pnpm, git 2.32+, tmux, Python 3.8+, GitHub CLI 2.48+, 그리고 DeepSeek Harness와 모델 공급자 설정이 필요해요. GitHub Enterprise Server는 지원하지 않습니다. 하네스의 LLM 계층은 공급자 중립 구조라서 pi-ai 어댑터, OpenAI 호환 게이트웨이, 자체 서버로도 요청을 보낼 수 있다고 README에 적혀 있어요. DeepSeek 모델 전용은 아니라는 뜻입니다. 다만 다른 모델로 Super-agent를 돌린 결과는 확인하지 못했어요.
글에는 있어도 공개판에는 없는 것
설계 글에 나오는 클라우드 저장·연산 분리, 외부 Watchdog 세션, 이메일·일정 이벤트는 공개 코드에 그 형태로 들어 있지 않아요. 보도들이 전한, 부르지 않아도 단체 채팅을 보고 해결책을 내놓는다는 장면은 DeepSeek 내부 인스턴스 사례입니다. 공개판은 기본이 observe라서 요청받지 않은 일은 기록만 해요.
공개된 속도·토큰 수치는 어떤 조건에서 나온 건가요?
수치를 보기 전에 시험 조건부터 짚어야 해요. DeepSeek Harness 팀은 모든 결과를 합성 부하 실험으로 얻었고, 원문에서 직접 초기 참고용이라고 밝혔습니다. 실행 1회에 메시지 약 300개가 들어갔고 그중 작업 요청이 약 20개였어요. 코딩은 시간만 쓰는 가짜 도구로 바꿨고, 메시지 간격과 작업 시간은 1/4로 줄였으며, 모델 호출 시간은 실제값이에요. 방식마다 5회씩 돌렸습니다. 그래서 이 시험이 보는 것은 코드 품질이 아니라 스케줄링과 협업 능력이에요.
| 수치 | 시험 조건 | 비교 대상 |
|---|---|---|
| 완료 시간 p50 12.4분, p95 15.7분 | 위 합성 시험. 작업 요청부터 결과 메시지까지 | 중성 프롬프트를 쓴 단일 세션 + Subagent 도구 방식의 p95 29.5분 (5회 중 Subagent 호출 0회) |
| 실행 1회 캐시 읽기 토큰 2323만 → 3177만 (약 37% 증가) | 같은 시험에서 구독 직통 기능을 끈 경우 | 직통을 켠 완전판 2323만 |
| Router가 내릴 결정 수 약 30% 증가 | 같은 시험에서 직통을 끈 경우. 완료 시간은 거의 같음 | 직통을 켠 완전판 |
| 결정 1건당 분담 추론 시간 6.4초 → 1.6초 | Router만 실제 모델, Worker는 Mock 모델. Trigger 도착 속도를 분당 약 1개에서 약 40개로 올린 압력 시험 | 부하가 낮을 때. 요청 1회 시간은 2.5초에서 3.9초로 오히려 늘었음 |
p95는 100번 중 95번이 이 시간 안에 끝난다는 뜻이고, p50은 중간값이에요. 첫 줄의 15.7분과 29.5분은 같은 합성 시험 안에서 두 방식을 견준 값입니다. Claude Code나 Codex와 같은 조건으로 잰 수치는 원문과 저장소 어디에도 없어요.
몇 가지를 더 읽어 둘게요. DeepSeek Harness 팀은 Super-agent가 독립 세션을 여러 개 유지하기 때문에 단일 세션보다 캐시 읽기 토큰을 더 쓴다고 직접 밝혔어요. 더 많은 토큰으로 완료 시간을 짧고 고르게 산다는 설명입니다. 위임 우선 프롬프트를 쓴 단일 세션 방식은 5회 중 4회 위임해 시간이 줄었지만 전체로는 Super-agent보다 느렸어요. 나머지 1회는 일이 작다고 판단해 직접 처리하다 긴 꼬리를 만들었습니다.
2323만에서 3177만으로 늘었다는 37%는 직통을 켠 완전판을 기준선으로 한 증가율이에요. 대상도 Router 토큰이 아니라 실행 1회 전체의 캐시 읽기 토큰입니다. 절감 비율로 뒤집어 읽으면 기준이 바뀌어 숫자가 달라져요. 6.4초에서 1.6초로 내려간 값도 다른 제품이나 이전 버전이 아니라 부하가 낮을 때와 높을 때를 견준 결과입니다.
숫자가 짧은 글로 옮겨지면서 조건이 떨어져 나간 사례도 있어요. X의 한 중국어 요약 게시물(2026-11-01)은 29.5분에서 15.7분으로 줄었다는 점을 조건 없이 크게 강조했습니다. 이 표의 조건 열을 함께 읽어야 같은 오해를 피할 수 있어요.
보안 한계는 어디까지 알려져 있나요?
DeepSeek 저장소가 직접 밝힌 한계부터 볼게요. 006 Deployment 문서에 따르면 두 프리셋 모두 danger-full-access 권한으로 운영자의 OS 사용자 권한에서 돌아갑니다. 원문은 이렇게 적었어요. "A worker can execute programs by path and read the operator's home directory. For isolation, use a dedicated OS account containing only the agent's credentials."
003 Execution 문서에 따르면 Executor 세션은 승인 없이 명령을 실행해요. 래퍼와 디렉터리는 기본값일 뿐 보안 경계가 아니라고 문서가 밝혔습니다.
메시지와 댓글 본문은 권한을 바꾸지 못하게 설계됐어요. 그래도 본문과 인용을 얼마나 믿을지는 007 Architecture 문서가 열린 질문으로 남겨 뒀습니다. 프롬프트 주입, 즉 에이전트가 읽는 글 안에 몰래 지시를 넣어 엉뚱한 행동을 시키는 공격이 여기서 문제가 돼요.
SETUP 문서는 에이전트를 운영자 본인 계정이 아니라 전용 GitHub 계정으로 돌리고 auto-merge는 기본 No로 두라고 권고합니다. deepseek-harness의 SAFETY.md는 더 직설적이에요. "It has not undergone a security audit and must not be treated as secure or production-ready." 설계 글 8.4절도 보안과 프라이버시를 잘 풀지 못하면 Super-agent는 작고 믿을 수 있는 범위에서만 일할 수 있다는 취지로 썼어요.
우리 팀 에이전트 설계에 가져갈 원칙은 무엇인가요?
원칙은 DeepSeek 저장소의 철학 문서(000 Philosophy)와 설계 글에서 가져왔어요. 철학 문서는 판단 기준을 한 문장으로 적었습니다. "Every part of the project is judged by the attention it costs." 아래 다섯 가지는 이 문서들을 팀 운영에 옮겨 본 제 풀이이고, DeepSeek이 직접 권고한 목록은 아니에요.
1. 사람이 볼 것만 보여 주는 보고 규칙
철학 문서는 에이전트가 말하는 조건을 이렇게 적었어요. "It speaks only when a person must act or can use a result." 004 Prompts 문서는 채팅 답을 "Chat messages are one sentence by default, with a hard limit of 100 words."로 정했고요. 소음에 대한 처방도 눈에 띕니다. 에이전트가 시끄러우면 프롬프트를 더 짧고 엄격하게 고치거나 잠시 멈추고, "Do not add more messages to explain the noise."라는 거예요.
2. 처음엔 기록만 하는 관찰 모드
"Start narrow. Begin with a short allowed list and with proactive work only recorded." 요청받지 않은 일은 팀이 쓴 규칙이 있어야 하고, 처음에는 했을 것을 기록만 하는 모드로 시작해요. 기록을 사람이 훑어본 뒤에 권한을 넓히면 됩니다. 물량도 경계 대상이에요. "Mass pull requests, broadcast messages and busywork cost the team more than they give."
3. 에이전트 전용 계정과 권한 분리
앞서 본 006 Deployment 문서의 문장이 그대로 체크리스트가 돼요. 에이전트가 읽고 쓰는 계정과 홈 디렉터리가 운영자 본인 것과 섞여 있지 않은지 보라는 겁니다. 전용 OS 계정과 전용 GitHub 계정을 따로 두고, auto-merge는 꺼 둔 채 시작해요.
4. 결정론 필터를 모델 앞에 두기
DeepSeek Harness 팀은 설계 글에서 2단 필터를 소개했어요. 허용 목록 같은 규칙은 코드가 먼저 판단하고, 애매한 후보만 모델이 봅니다. 모델이 판단해야 할 후보 자체를 줄이는 구조예요. 에이전트가 읽는 입구가 늘수록 이 앞단이 하는 일이 커집니다.
5. 실행자와 사람 사이에 창구 하나 두기
설계 글에서 Worker는 사람과 직접 말하지 않고 Router에 보고하며, Router가 사용자에게 통일해 답해요. 에이전트가 몇 개 돌든 사람은 한 목소리와 대화한다는 뜻입니다. 이 창구가 지켜야 할 약속도 철학 문서에 있어요. "a failure is reported as a failure, and a limit is never bypassed to avoid asking." 진행 감시를 바깥 Watchdog에 맡긴다는 구상도 설계 글에 나오지만, 공개 코드에는 그 형태로 들어 있지 않습니다.
마무리
DeepSeek Super-agent는 제품 발표가 아니라 설계 구상과 연구 코드의 공개예요. Bloomberg는 Claude Code를 겨냥한 것이라고 보도했고, DeepSeek 스스로는 참고용 프로토타입이라고 밝혔습니다. 공개 수치는 합성 부하 시험값이라 다른 도구와 줄 세울 근거가 없어요. 읽을 가치가 있는 부분은 사람의 주의력을 비용으로 보고 에이전트 설계를 거기서 시작했다는 점입니다. 수치와 저장소 현황은 2026-11-02 조회 기준이에요.
우리 팀 에이전트로 옮겨 보려면 세 가지만 스스로 점검해 보세요.
- 에이전트가 사람에게 말을 거는 조건과 길이가 글로 적혀 있나요?
- 요청하지 않은 일을 하는 에이전트에게, 먼저 기록만 하는 단계가 있나요?
- 에이전트가 쓰는 계정과 권한이 내 계정과 분리돼 있나요?
천천히 검토하셔도 됩니다. 우리 팀 에이전트 보고 규칙부터 확인해 보세요.
자주 묻는 질문
DeepSeek Super-agent를 바로 팀 업무에 써도 되나요?
권하지 않아요. DeepSeek은 README에서 "Treat it as research code, not production-ready software."라고 밝혔습니다. 2026-11-02 17:41 KST 조회 기준 커밋이 1개이고 릴리스는 0건이며, 두 프리셋 모두 운영자 OS 사용자 권한으로 돌아요.
DeepSeek 모델이 아니면 Super-agent를 돌릴 수 없나요?
바탕이 된 DeepSeek Harness가 공급자 중립 구조라서 모델이 DeepSeek 전용이라고 볼 근거는 없어요. README는 pi-ai 어댑터, OpenAI 호환 게이트웨이, 자체 서버로 요청을 보낼 수 있다고 적었습니다. 다만 다른 모델로 Super-agent를 돌린 결과는 확인하지 못했어요.
사람이 동시에 3~5개 세션까지만 따라갈 수 있다는 건 연구 결과인가요?
연구 결과는 아니에요. DeepSeek Harness 팀이 설계 글에서 우리가 관찰한 바로는 그렇다고 쓴 진술이고, 표본 수나 조사 설계는 제시되지 않았습니다. 인용할 때는 관찰이라고 밝혀 주세요.
Super-agent가 Claude Code보다 빠른가요?
비교할 수 있는 수치가 없어요. 29.5분은 중성 프롬프트를 쓴 단일 세션 + Subagent 도구 방식의 p95이고, 합성 부하 시험에서 DeepSeek Harness 팀이 직접 잰 값입니다. Claude Code나 Codex와 같은 조건으로 잰 수치는 원문과 저장소 어디에도 없어요.
부르지 않아도 알아서 버그를 고쳐 주나요?
공개판의 기본 동작은 아니에요. 그 장면은 설계 글이 소개한 DeepSeek 내부 인스턴스 사례이고, 공개 프로토타입은 기본값이 observe라서 요청받지 않은 일은 했을 일로 기록만 합니다. auto 모드로 바꿔야 그런 판단을 실제로 수락해요.